例: SQLclを使用したChicago Crime Data (CSV)のロード (2025/02/28)
例: SQLclを使用したChicago Crime Data (CSV)のロード (2025/02/28)
https://www.thatjeffsmith.com/archive/2025/02/example-loading-chicago-crime-data-csv-with-sqlcl/
私も皆さんの多くと同じように物事を学びます。
- 読書(ブログ!)
- そのことをする
- そしておそらく、私がブログで読んだことを実行することによって
私は23aiのAIベクトル検索について調べているところです(ええ、私はただの人間です)。そして、私にとって新しい概念の1つが、階層型ナビゲーション可能なスモールワールド(HNSW)インデックスです。
私が現在読んでいるブログは、当社のプロダクトマネージャーであるアンディ・リベネスによる「AIベクトル検索におけるHNSWベクトルインデックスの使用」という記事です。
これらの新しいタイプのインデックスを使用してベクトルを比較し始めると、実行プランが何を示しているのかをよりよく理解できるようになることを期待しています。たとえば、
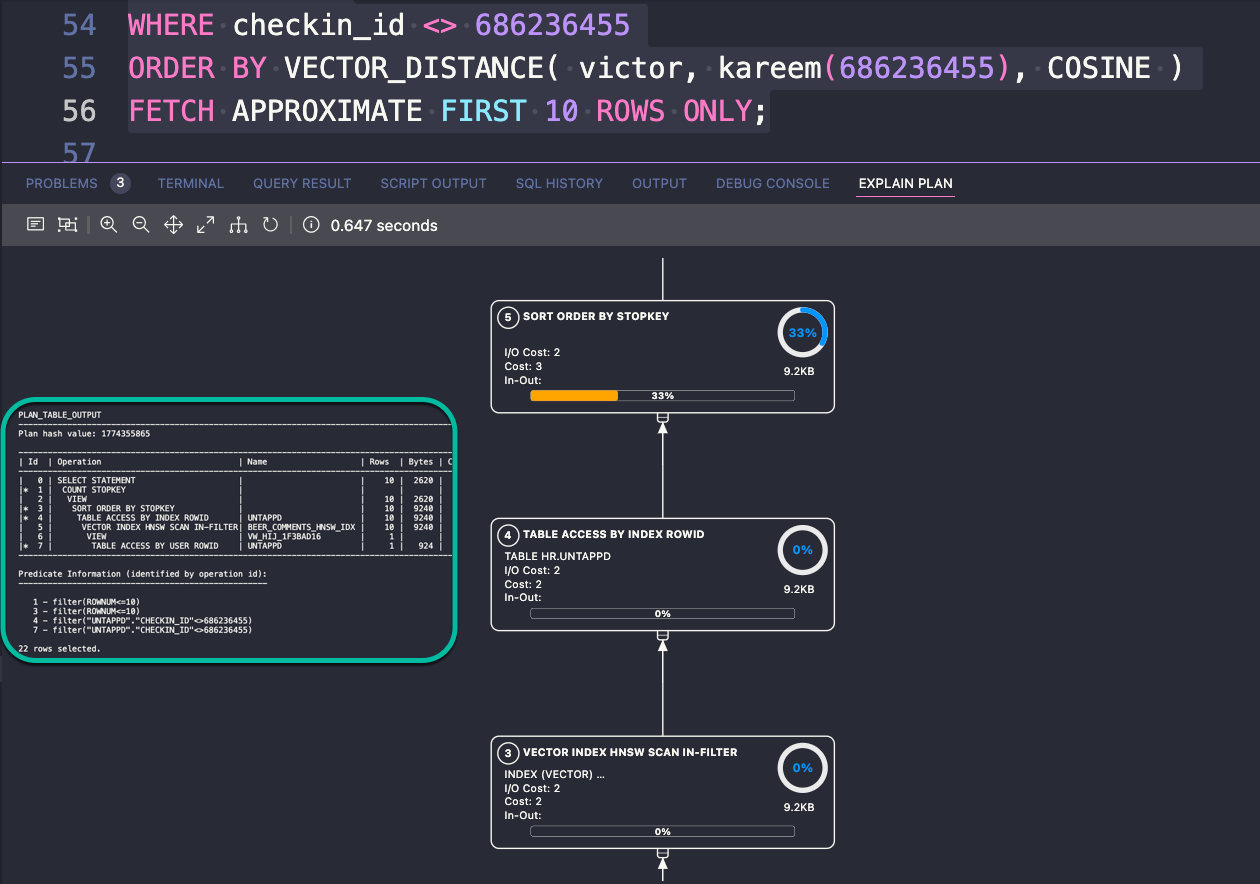
アンディのHNSWの投稿はこのデータセットを使用しているので、読み込んでみましょう!
シカゴのデータポータルには「2001年から現在までの犯罪」データセットがあり、そのCSV版をダウンロードするつもりです。
ダウンロードが完了したら、私が通常行う手順は以下のとおりです。
SQLclを起動し、LOADコマンドを使用してDDLを生成します。
「CD」コマンドを使ってダウンロードフォルダに移動し、次に「SHOW」キーワード付きのLOADコマンドを使って、この新しいCSVデータをテーブルに変換した場合にLOADコマンドがどのような処理を行うかを確認します。
注:私は一切設定を行っていません。これは単に「まあ、これで十分かもしれない」という私の試みです。
SQL> cd /users/thatjeffsmith/downloads
SQL> load crime_data chicago-crimes.csv show

csv
column_names on
delimiter ,
enclosures ""
double
encoding UTF8
row_limit off
row_terminator default
skip_rows 0
skip_after_names

Show DDL for table HR.CRIME_DATA

#INFO COLUMN 2: Case Number => CASE_NUMBER
#INFO COLUMN 3: Date => DATE$
#INFO COLUMN 4: Block => BLOCK
#INFO COLUMN 6: Primary Type => PRIMARY_TYPE
#INFO COLUMN 7: Description => DESCRIPTION
#INFO COLUMN 8: Location Description => LOCATION_DESCRIPTION
#INFO COLUMN 9: Arrest => ARREST
#INFO COLUMN 10: Domestic => DOMESTIC
#INFO COLUMN 11: Beat => BEAT
#INFO COLUMN 12: District => DISTRICT
#INFO COLUMN 13: Ward => WARD
#INFO COLUMN 14: Community Area => COMMUNITY_AREA
#INFO COLUMN 15: FBI Code => FBI_CODE
#INFO COLUMN 16: X Coordinate => X_COORDINATE
#INFO COLUMN 17: Y Coordinate => Y_COORDINATE
#INFO COLUMN 18: Year => YEAR
#INFO COLUMN 19: Updated On => UPDATED_ON
#INFO COLUMN 20: Latitude => LATITUDE
#INFO COLUMN 21: Longitude => LONGITUDE
#INFO COLUMN 22: Location => LOCATION

CREATE TABLE HR.CRIME_DATA
 (
  ID NUMBER(10),
  CASE_NUMBER VARCHAR2(26),
  DATE$ VARCHAR2(128),
  BLOCK VARCHAR2(128),
  IUCR VARCHAR2(26),
  PRIMARY_TYPE VARCHAR2(128),
  DESCRIPTION VARCHAR2(128),
  LOCATION_DESCRIPTION VARCHAR2(128),
  ARREST VARCHAR2(26),
  DOMESTIC VARCHAR2(26),
  BEAT VARCHAR2(26),
  DISTRICT VARCHAR2(26),
  WARD NUMBER(4),
  COMMUNITY_AREA NUMBER(4),
  FBI_CODE VARCHAR2(26),
  X_COORDINATE NUMBER(9),
  Y_COORDINATE NUMBER(9),
  YEAR NUMBER(6),
  UPDATED_ON VARCHAR2(128),
  LATITUDE NUMBER(13, 9),
  LONGITUDE NUMBER(13, 9),
  LOCATION VARCHAR2(128)
 )
;

SUCCESS: Processed without errors
SQL>
 危険信号:日付をVARCHAR型に変換
DATE$ VARCHAR2(128) -- うわ、いやいやいやなぜこれが問題なのでしょうか?これらの日付を日付としてクエリしたい場合、変換関数を使用する必要がありますが、これは本来あるべきように日付として保存する場合よりも見苦しく、処理速度も遅くなります。
この問題を解決するには、LOADコマンドに対して、ファイルからテーブルにデータをストリーミングする際にどのような日付形式を想定しているかを伝える必要があります。
データをちょっと覗いてみましょう
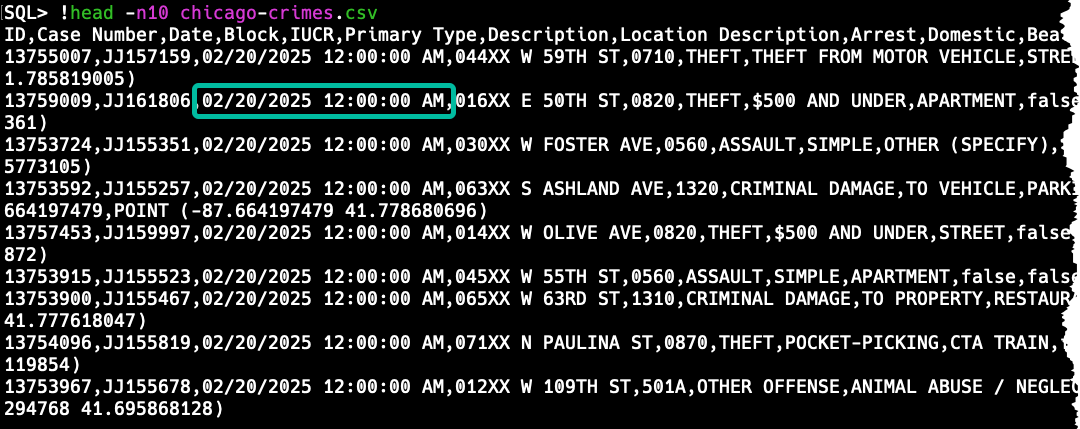
よし、これでシカゴのデータポータルが犯罪発生時にどのように情報伝達を行うかがわかった。次はそれをSQLclに伝える必要がある。
負荷を表示して負荷を設定します
「show load」コマンドを実行すると、ロードジョブを実行するための現在の設定が表示されます。
SQL> show load
batch_rows 50
batches_per_commit 10
clean_names transform
column_size rounded
commit on
date_format
errors 50
map_column_names off
method insert
timestamp_format
timestamptz_format
locale
scan_rows 100
truncate off
unknown_columns_fail on
SQL> set load date_format MM/DD/YYYY HH:MI:SS AM
これで準備ができたので、もう一度LOADコマンドを試してみましょう。
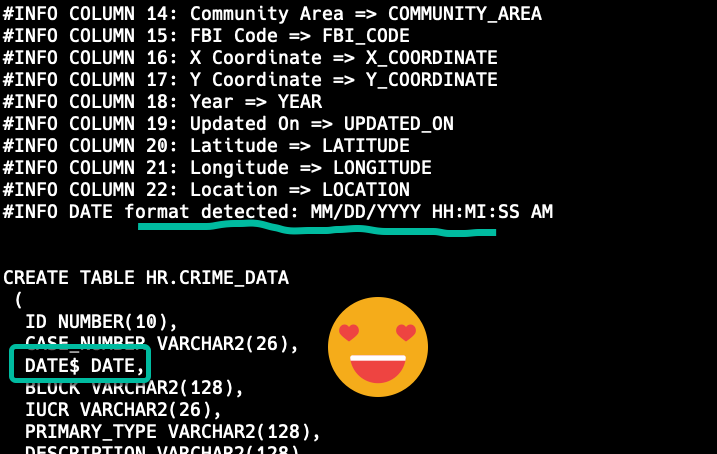
新しい列名は嫌いだけど、列名の変更は簡単だから、さっさと読み込もう!
新しいテーブルの作成/読み込み
load コマンドでは、末尾に 'show' キーワードを使用する代わりに、単に 'new' を使用します。
SQL> load crime_data chicago-crimes.csv new

csv
column_names on
delimiter ,
enclosures ""
double off
encoding UTF8
row_limit off
row_terminator default
skip_rows 0
skip_after_names

Create new table and load data into table HR.CRIME_DATA
batch_rows 50
batches_per_commit 10
clean_names transform
column_size rounded
commit on
date_format MM/DD/YYYY HH:MI:SS AM
errors 50
map_column_names off
method insert
timestamp_format
timestamptz_format
locale English United States
scan_rows 100
truncate off
unknown_columns_fail on

#INFO COLUMN 2: Case Number => CASE_NUMBER
#INFO COLUMN 3: Date => DATE$
#INFO COLUMN 4: Block => BLOCK
#INFO COLUMN 6: Primary Type => PRIMARY_TYPE
#INFO COLUMN 7: Description => DESCRIPTION
#INFO COLUMN 8: Location Description => LOCATION_DESCRIPTION
#INFO COLUMN 9: Arrest => ARREST
#INFO COLUMN 10: Domestic => DOMESTIC
#INFO COLUMN 11: Beat => BEAT
#INFO COLUMN 12: District => DISTRICT
#INFO COLUMN 13: Ward => WARD
#INFO COLUMN 14: Community Area => COMMUNITY_AREA
#INFO COLUMN 15: FBI Code => FBI_CODE
#INFO COLUMN 16: X Coordinate => X_COORDINATE
#INFO COLUMN 17: Y Coordinate => Y_COORDINATE
#INFO COLUMN 18: Year => YEAR
#INFO COLUMN 19: Updated On => UPDATED_ON
#INFO COLUMN 20: Latitude => LATITUDE
#INFO COLUMN 21: Longitude => LONGITUDE
#INFO COLUMN 22: Location => LOCATION
#INFO DATE format detected: MM/DD/YYYY HH:MI:SS AM


CREATE TABLE HR.CRIME_DATA
 (
  ID NUMBER(10),
  CASE_NUMBER VARCHAR2(26),
  DATE$ DATE,
  BLOCK VARCHAR2(128),
  IUCR VARCHAR2(26),
  PRIMARY_TYPE VARCHAR2(128),
  DESCRIPTION VARCHAR2(128),
  LOCATION_DESCRIPTION VARCHAR2(128),
  ARREST VARCHAR2(26),
  DOMESTIC VARCHAR2(26),
  BEAT VARCHAR2(26),
  DISTRICT VARCHAR2(26),
  WARD NUMBER(4),
  COMMUNITY_AREA NUMBER(4),
  FBI_CODE VARCHAR2(26),
  X_COORDINATE NUMBER(9),
  Y_COORDINATE NUMBER(9),
  YEAR NUMBER(6),
  UPDATED_ON DATE,
  LATITUDE NUMBER(13, 9),
  LONGITUDE NUMBER(13, 9),
  LOCATION VARCHAR2(128)
 )
;

#INFO Table created
#INFO Number of rows processed: 28,268
#INFO Number of rows in error: 0
#INFO Last row processed in final committed batch: 28,268
SUCCESS: Processed without errors
SQL>
これは想定通りの結果でしょうか?読み込まれたレコードとファイルの内容を比較してみましょう。
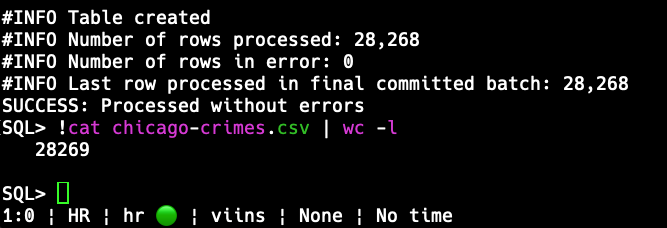
はい、その通りです。CSVヘッダーという余分なレコードがあり、それが行として読み込まれません。
表を見てみましょう
まずは統計データを収集しましょう。
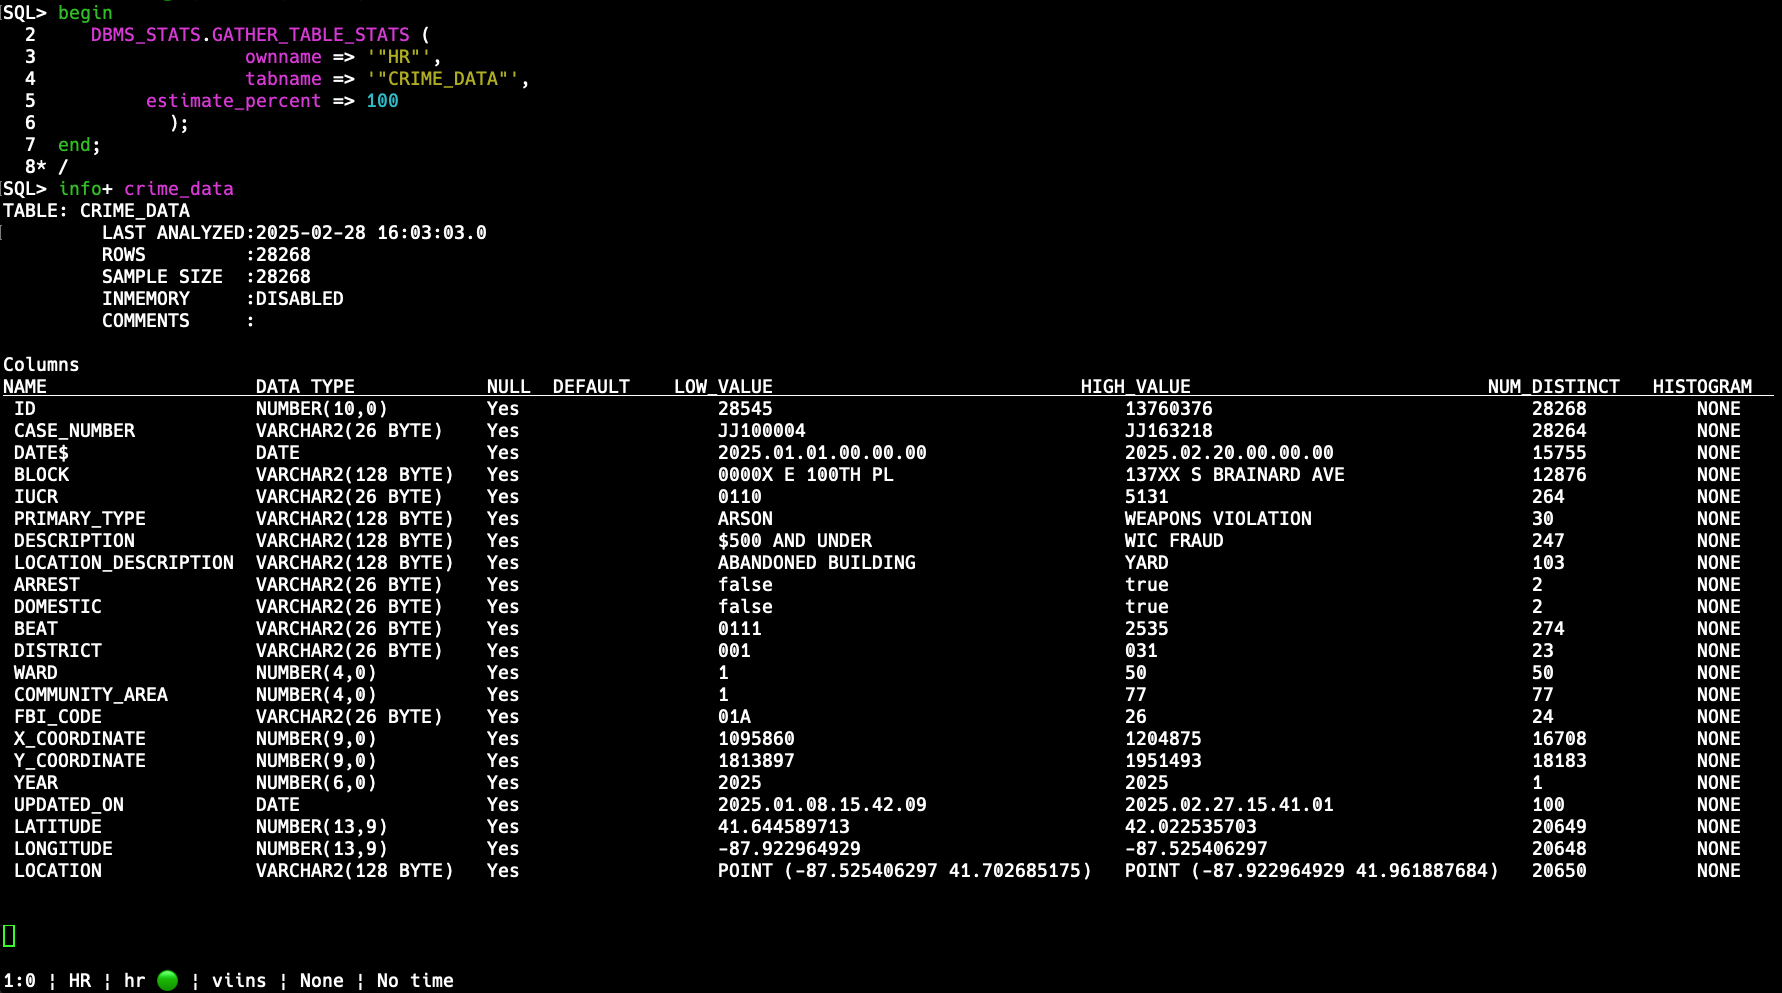
INFO+はDESCのようなものですが、さらに強化された、良い意味での機能強化版です!テーブル定義を表示するだけでなく、統計情報も追加してくれます。
その列の名前を変更しましょう
それにはVS Codeと弊社のSQL Developer拡張機能を使用できます。
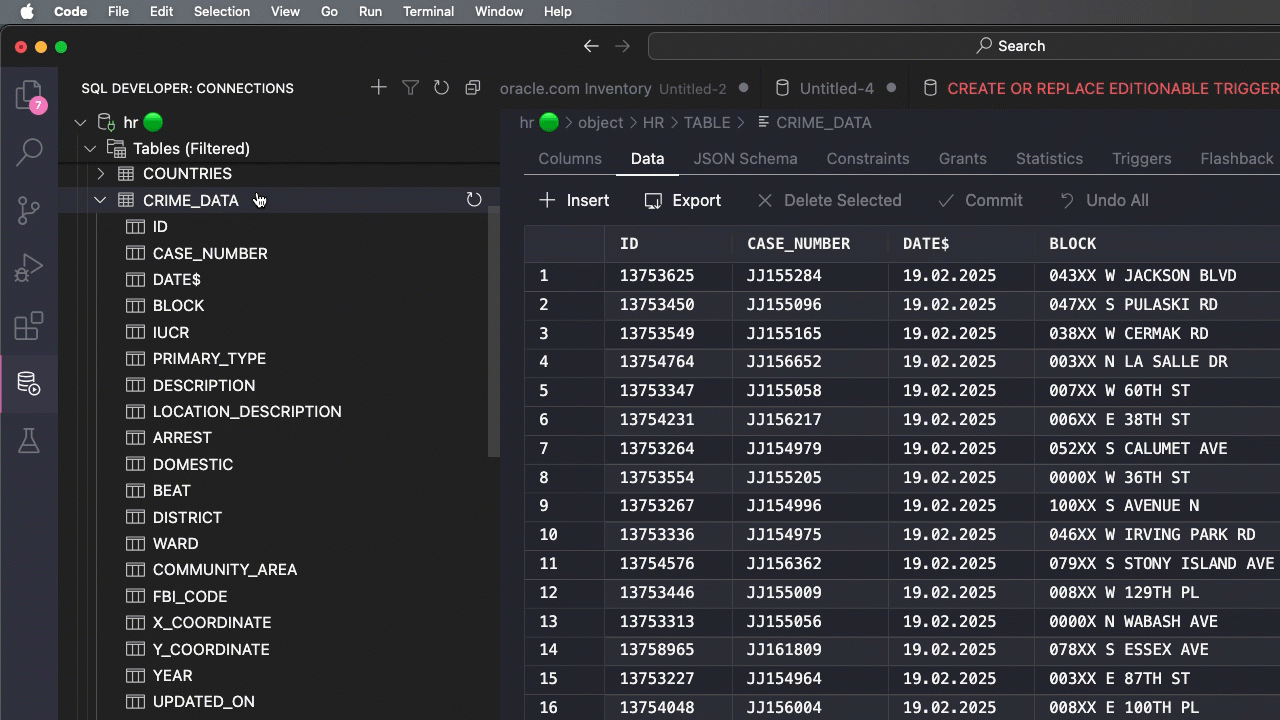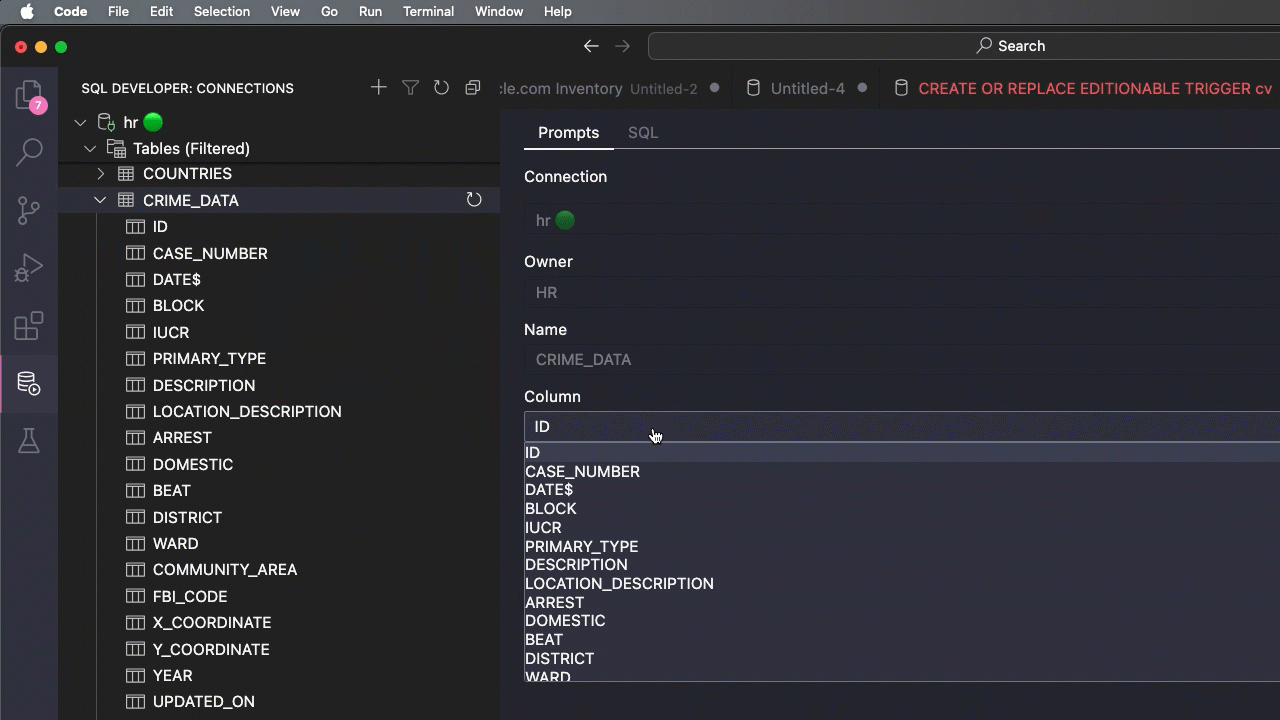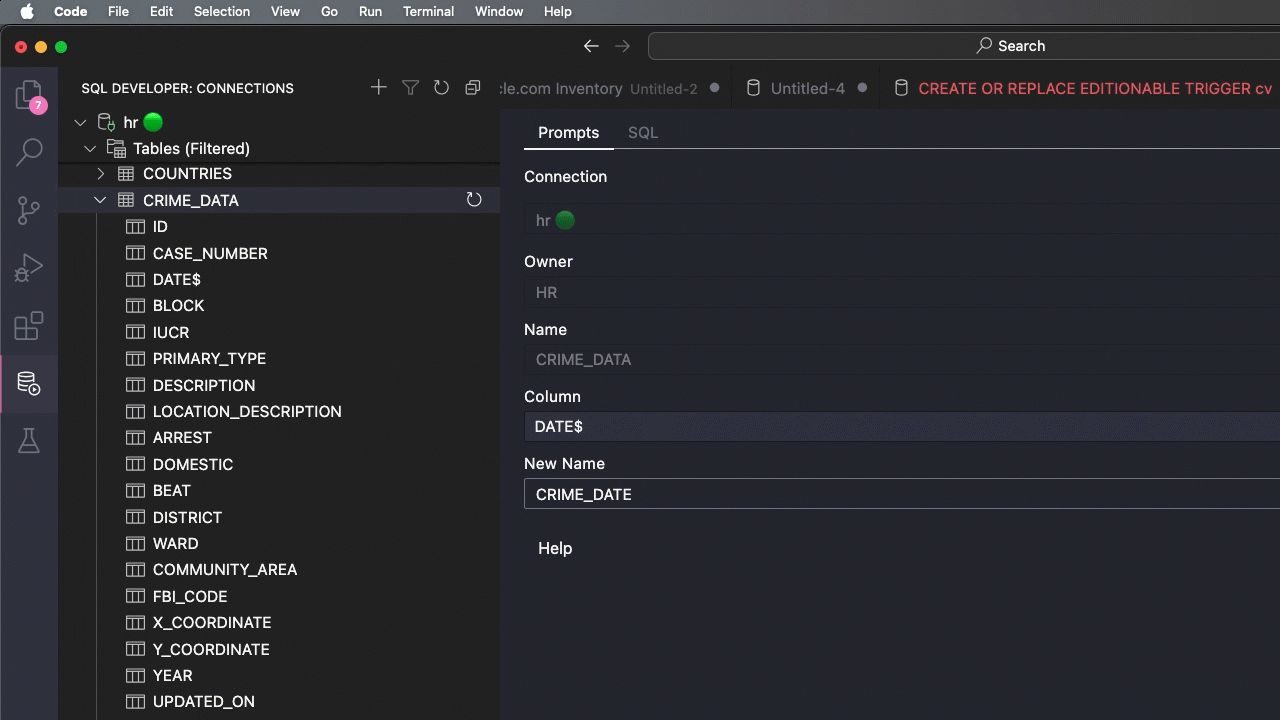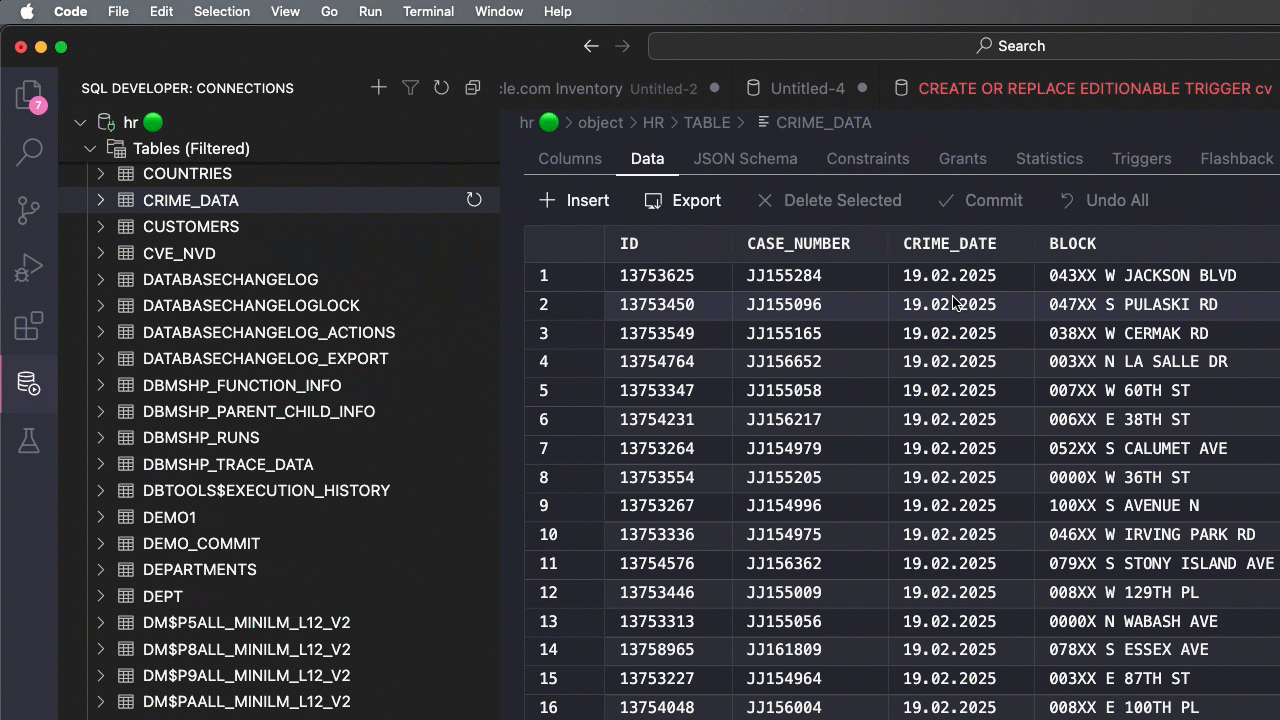
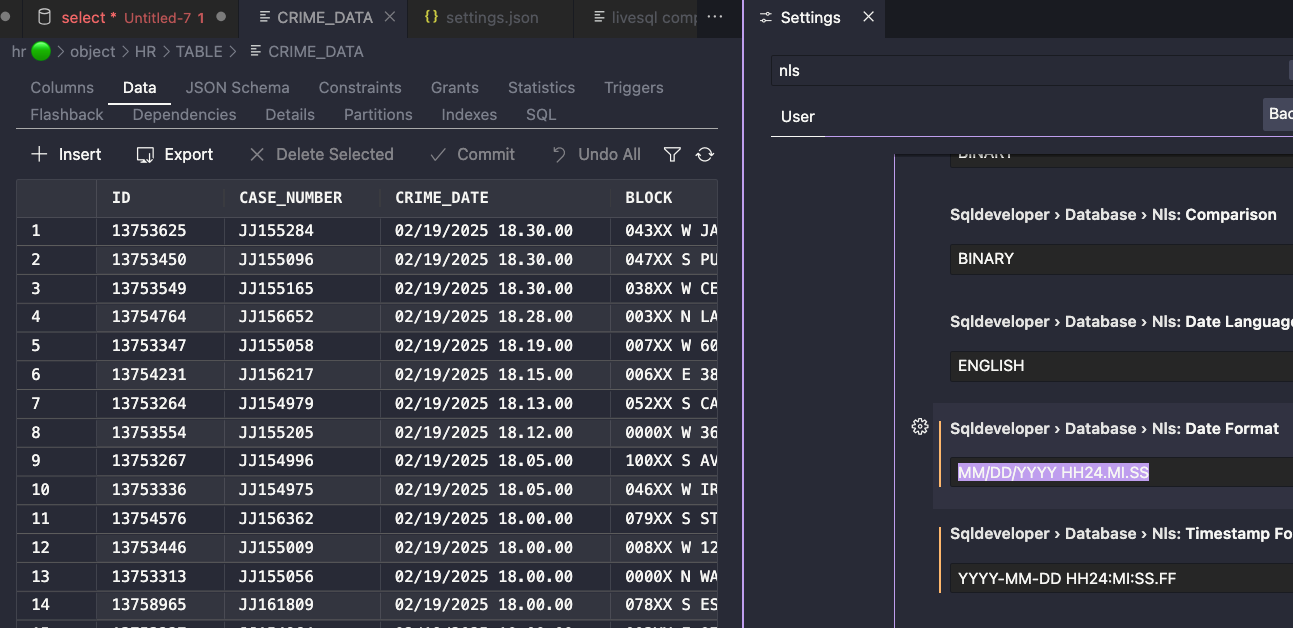
あ、日付の形式がおかしいですね。それも修正しましょう。
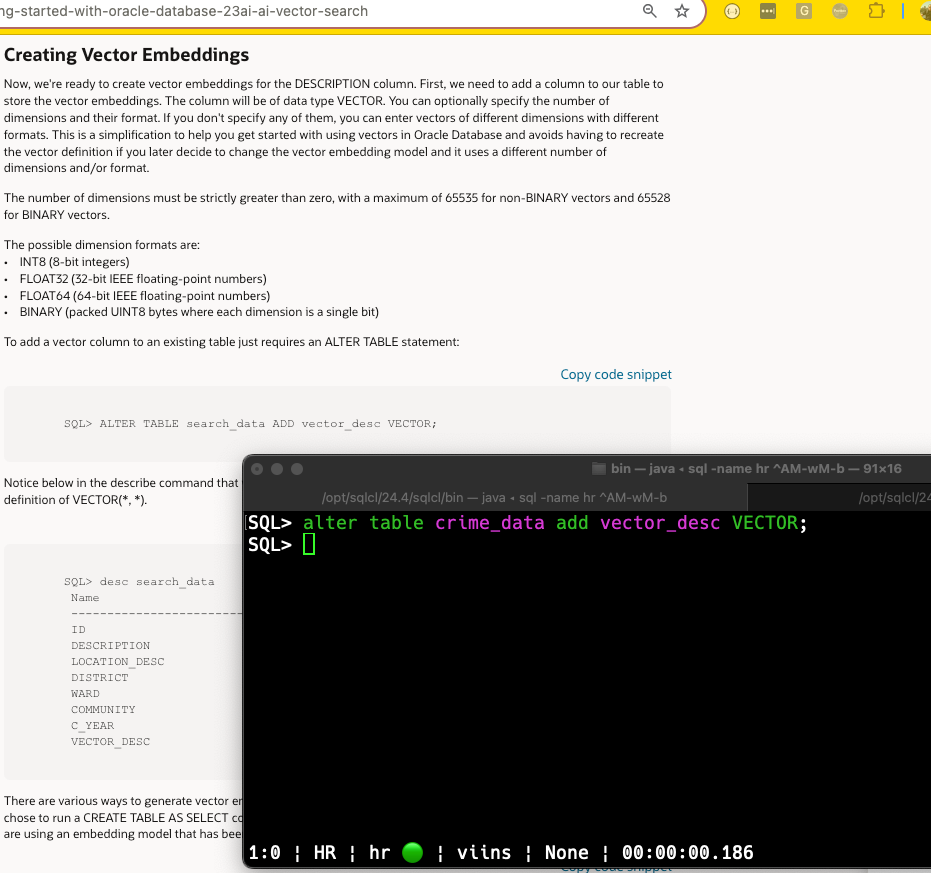
データが揃ったので、アンディのAIベクトル検索入門記事を参考にしながら、実際に操作して学ぶことができます。
ここまで読んでくださったあなたへ…
私がCSVファイルからOracleデータベースのテーブルにデータをロードする方法について解説している他の記事もぜひご覧ください。


コメント
コメントを投稿