Oracle Autonomous AI Lakehouseで10xを超えるトークン使用を削減 (2026/10/26)
Oracle Autonomous AI Lakehouseで10xを超えるトークン使用を削減 (2026/10/26)
投稿者:Onur Kocberber | Directory of Software Development
Oracle AI Lakehouseは、基盤となるデータを移動することなく、Oracle Databaseおよび非Oracle Databaseとカタログ全体へのリアルタイムアクセスを提供します。これにより、顧客の既存のデータ環境全体にわたって、データアクセス、ガバナンス、分析、およびAIを統合できます。
Oracle AI Lakehouseは、AI Data Catalog(AI-Cat)を通じて、Oracleおよび非Oracleソース間で共有されるセマンティックレイヤーを提供します。ネイティブOracle Databaseのアノテーション、分析ビュー、およびリレーションシップで定義されたビジネス上の意味を再利用することで、各アプリケーションでデータを移動したり定義を再構築したりすることなく、顧客の知的投資を維持します。カタログのアノテーションとエンリッチメントにより、このコンテキストがより広範なデータ環境全体に拡張されます。
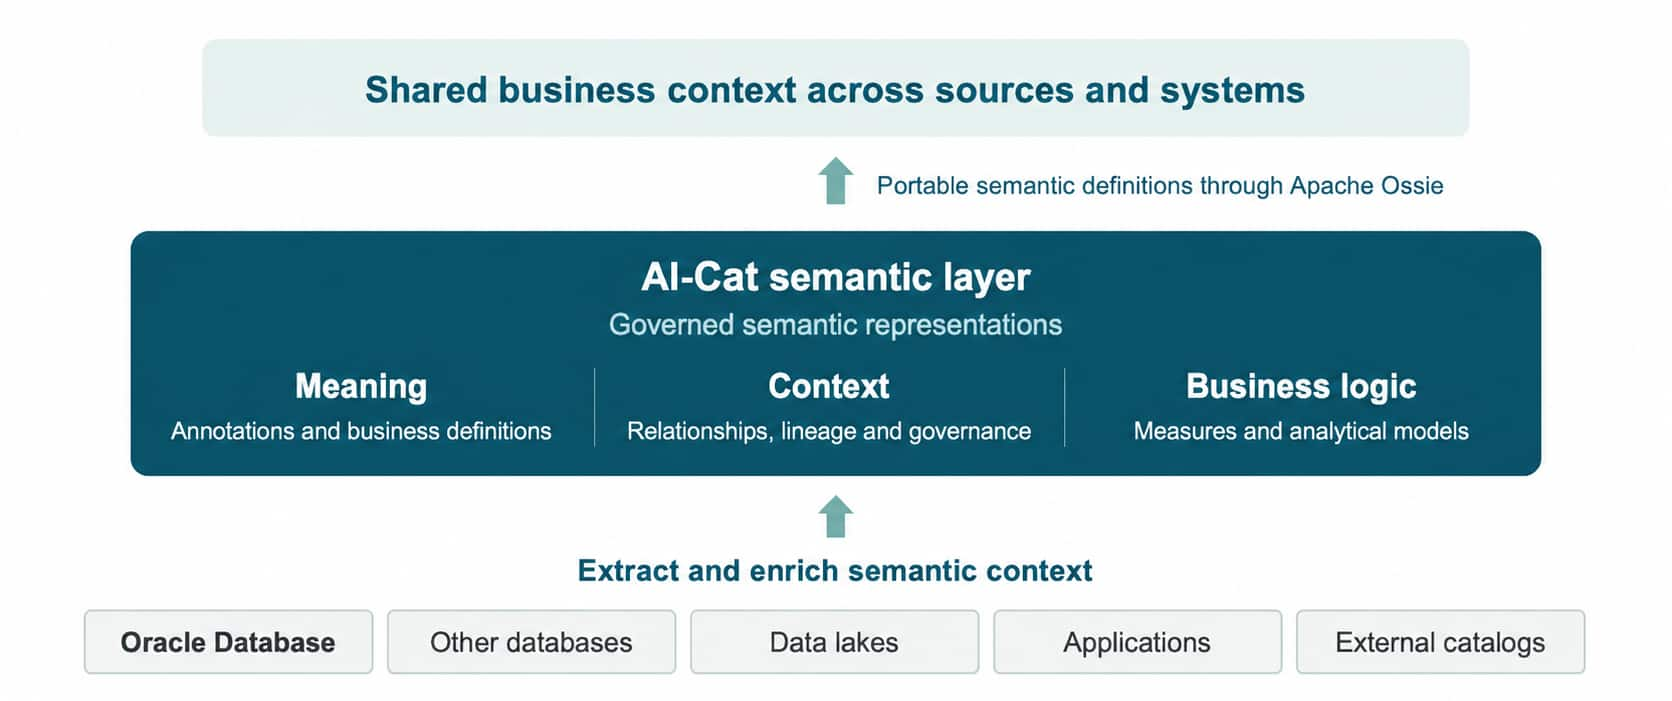
図1. 複数の情報源からのセマンティック情報が、データ資産全体で共有されるビジネスコンテキストを形成する。
データに意味論的な意味が必要な理由
AIエージェントは、ユーザーが企業データを探索し、SQLを生成し、ビジネス上の疑問に答えるための手段として普及しつつあります。しかし、これらの作業を行うには、まずどのデータが関連性があるかを特定し、その意味を理解する必要があります。
データとメタデータが増大するにつれ、エージェントはカタログ、スキーマ、テーブル、列など、技術的な名称からはビジネス上の意味がほとんど読み取れないような複雑な要素をナビゲートする必要に迫られる。広範囲にわたる検索はコンテキスト情報と処理時間を消費する一方、発見においてはユーザーの権限を尊重しなければならない。
図2は、「2027会計年度第2四半期の各月における地域別の年初来売上高はいくらですか?」という質問に対する回答を比較したものです。暦上の第2四半期を想定したり、年初来売上高を計算する前に第2四半期に絞り込んだりすると、誤解を招く結果になる可能性があります。分析ビューでは、会計年度のカレンダーを定義し、第2四半期を選択する前に会計年度の開始日から売上高を累積します。
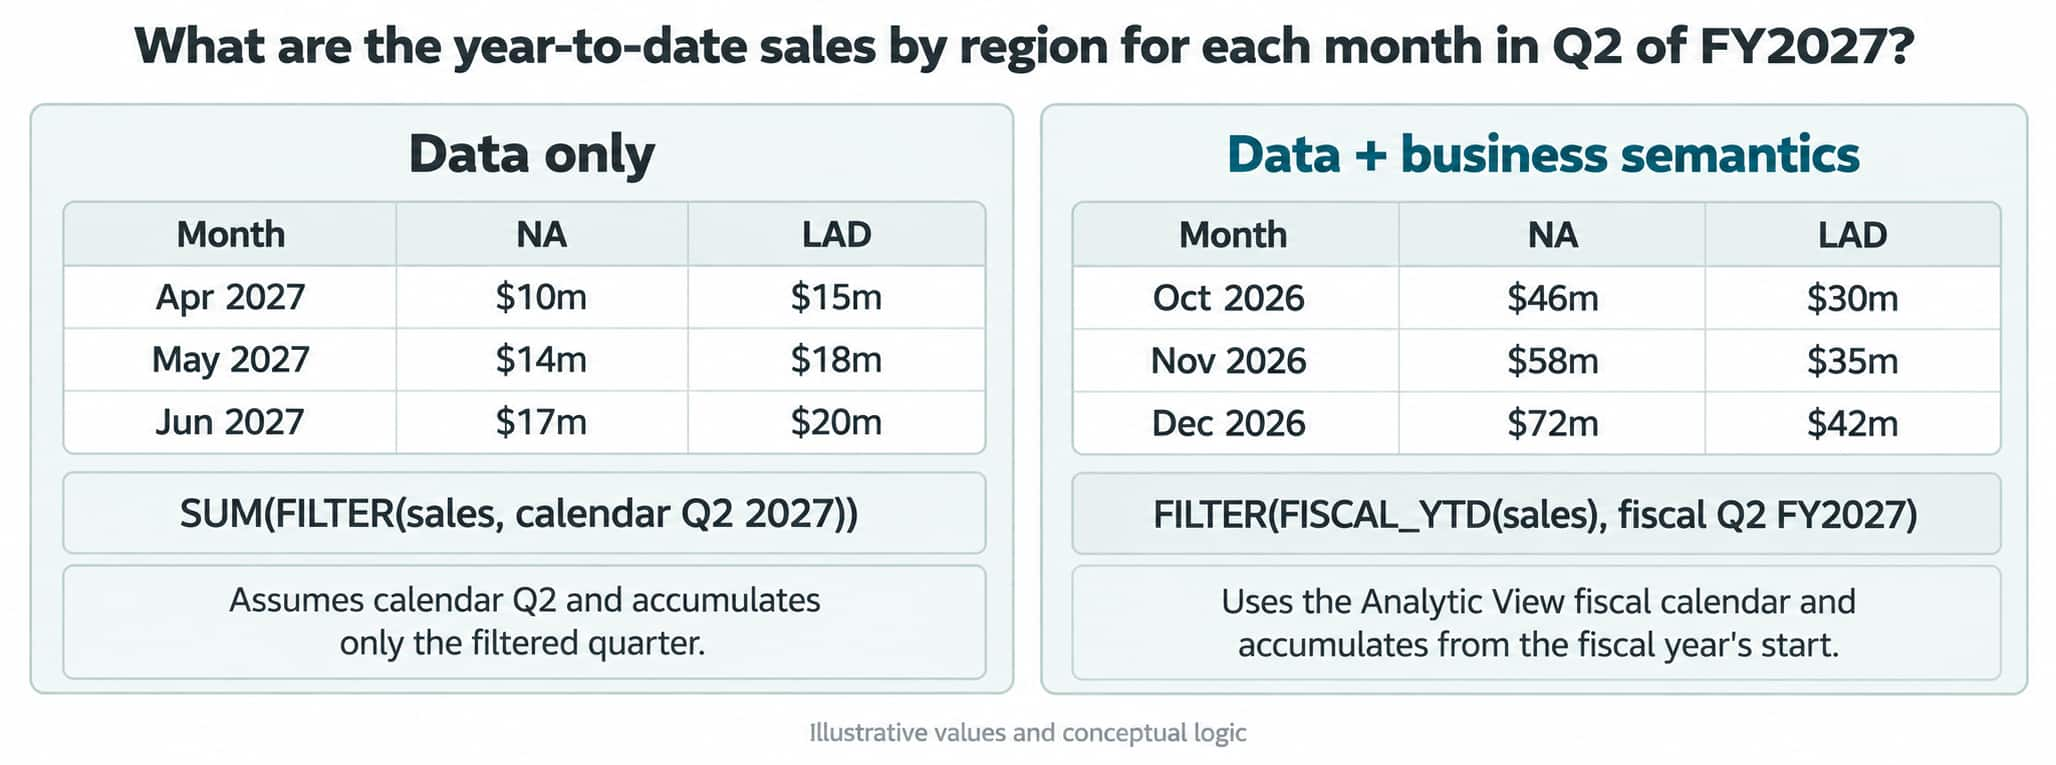
図2.財政的な定義がない場合、もっともらしい年初来累計の回答でも、間違った月や合計値を使用する可能性がある。
1. レイクハウス規模のエージェント型AI

図3.カタログ階層は、エージェントがナビゲートしなければならないコンテキストを拡大する。
レイクハウス規模では、自然言語分析でビジネスの意味を解釈し、エンタープライズ・ソース全体でコンテキストを選択する必要があります。図3の展開階層は、3つの課題のうちの1つです。
- Scaleは、カタログ、スキーマ、テーブル、列など、複数の範囲にわたって検索範囲を拡大します。
- 異なるモダリティでは、エージェントが異なる種類のデータとメタデータを解釈する必要がある。
- ガバナンスとアクセスルールは情報源によって異なり、エージェントが使用できる情報を決定する。
ユーザーの質問に基づかずに広範なメタデータをLLMに渡すと、レイテンシが増加し、誤った回答が発生するリスクが高まります。また、無関係なメタデータはトークンの無駄遣いにもなります。
意味コンテキストとカタログエージェント

図4.セマンティック層アーキテクチャは、カタログエージェントと統制された表現を接続する。
図4は、AI-Catのセマンティックレイヤーアーキテクチャを示しています。これらの例は、エージェント検索とセマンティックエンリッチメントを示しています。その他のエージェントタイプやより豊富な表現方法は、今後の開発ロードマップに含まれています。
カタログエージェントは、注釈、関係性、および共有定義を使用して、AI-Cat API を介して関連する承認済みアセットを返します。その後、コンシューマーエージェントはそのコンテキストを使用して SQL を生成したり、その他のタスクを実行したりします。
エージェント検索およびプルーニング
エージェント検索は、AI-Cat内で直接動作するエージェントを使用します。ユーザーの質問に基づいてカタログとスキーマを絞り込み、テーブルと列のメタデータを検査します。注釈により、名前が分かりにくい場合でも関連するテーブルを特定できます。カタログツールは、処理全体を通してユーザーの権限を適用し、エージェントは後続の処理に適した候補を返します。
ロールベースアクセス制御(RBAC)とは、同じ質問でも、メタデータのアクセス権限が異なるユーザーに対して異なる結果を返すことができる仕組みです。アプリケーションは、エージェントごとに個別のメタデータアクセスポリシーを実装するのではなく、検索時にAI-Catの認証情報を再利用します。
カタログ内でこの探索を行う理由
標準カタログAPIもアクセス権限を強制しますが、広範囲な検索を繰り返すと、クライアント側の処理とコンテキストのオーバーヘッドが増加します。AI-Cat以外でメタデータを保持するアプリケーションは、コピーを同期し、アクセス制御を維持する必要があります。検索APIはカタログ内を探索し、絞り込んだ候補を返します。
エージェントプルーニングの仕組み

図5. エージェント検索はカタログ内のメタデータを整理する。標準APIでは、繰り返し行われる探索はユーザーエージェントに任される。
図5では、エージェントがユーザーがアクセス権限を持つスキーマを絞り込み、次に検査が必要なスキーマとテーブルを計画します。メタデータツールは選択された説明とプロパティを並列バッチで取得するため、LLMはカタログ全体を受け取ることなく関連する詳細を評価できます。
エージェント検索の実践
「どの病院の手術が最も高額で、どの医師がその手術に関わっているか?」という質問に対して、下流のエージェントは、SQLを構築する前に、手術費用、実施された手術、および医師の情報を特定する必要があります。
OracleとIcebergのカタログ全体を通して、AI-Catは83のスキーマを2つに、736のテーブルを4つの候補に絞り込みます。17の列を検査した結果、IcebergテーブルはProcedure、Undergoes、Physicianの3つに絞り込まれました。

図6. OracleカタログとIcebergカタログを横断する階層的検出により、3つのIcebergテーブルが選択されます。
クライアントメタデータトークンとレイテンシを削減する
図3は、エンタープライズ規模のカタログの複雑さを示しています。別の実験では、5,000個のテーブルと約50,000個の注釈を使用しました。リストAPIのみの場合と、同じAPIにAgentic Searchを追加した場合を比較しました。比較には、実験実施時に利用可能だった最新のOpenAIモデルを搭載したCodexを使用しました。
表1. カタログ側エージェント検索ありとなしの結果
| メトリック | APIのみを一覧表示 | リストAPIとエージェント検索 | 削減 |
|---|---|---|---|
| カタログ応答サイズ | 602KB | 0.768 KB | 99.9% |
| 合計トークン数: Codex+AI-Cat | 114万人 | 329,000 | 71% |
| Codexトークン | 114万人 | 60,000 | 94.7% |
| 正規化されたクライアント遅延 | 1回 | 0.22倍 | 78% |
要点:テストした構成では、Agentic SearchによりCodexクライアントのレイテンシが78%削減され、メタデータ量とトークン使用量も減少しました。
2. 複数の情報源から意味情報を統合する
Oracle Databaseは、ミッションクリティカルなワークロードにおいて、注釈、ビジネス定義、ワークロード情報、分析ビューなど、豊富な意味情報を保持します。
AI-Catは、ソースコードで管理される定義とカタログの注釈およびエンリッチメントを組み合わせることで、このセマンティックな投資をOracleデータと非Oracleデータの両方で再利用できるようにし、Oracleからデータを移動させることなく実現します。
Oracleおよびその他のソース間で注釈を再利用する
AI-Catは、サポートされているOracleデータベースから既存のアノテーションをカタログに読み込み、データベースオブジェクトで定義された意味を保持して、利用するアプリケーション間で再利用できるようにします。
例えば、注釈によってCUSTOMER_EXT.PNが米国の電話番号であることが識別されます。CUSTOMER_EXTはオブジェクトストレージデータ上のOracle外部テーブルであり、注釈はそれにアクセスするために使用されるOracle列に定義されます。

図7.ソースおよびカタログの注釈は、データ資産全体にわたってビジネス上の意味を拡張する。
その他のカタログ化されたアセットについては、基となるソースにネイティブの注釈機能がない場合でも、チームはAI-Catに直接注釈を添付できます。
アノテーションを超えた豊富なOracle Databaseのセマンティックコンテキストを活用する
クエリ履歴には、スキーマメタデータで宣言されていないリレーションシップを含む実行された結合、繰り返し使用されるフィルタ、エイリアス、および式が記録されます。Oracle Databaseには既にこのコンテキストが含まれていますが、スキーマのみのアクセスではエージェントに公開されません。データ値は、ビジネス概念がどのように表現されるかをさらに明確にします。
図8では、スキーマメタデータだけでは、2007年に公開された否定的なレビューに対して無効な年フィルタが生成されます。データコンテキストはNEGATIVEを、クエリ履歴はSUBSTR(creationDate, 1, 4)を提供します。クエリ時にこのコンテキストを取得することで、フィルタの選択は実際の値と確立された式に基づいて行われます。

図8.データ値とクエリ履歴は、生成されたSQLに補完的なコンテキストを提供する。
分析ビューでは、厳選された指標、計算式、集計ルール、ディメンション、階層構造が追加されます。監査情報にはデータ使用状況が記録され、セキュリティポリシーではアクセス制限が定義されます。AI-Catを通じてこのコンテキストを公開することで、エージェントは資産の選択やビジネス指標の解釈を一貫して行うことができます。
3. AI支援による意味定義とデータ資産全体にわたる移植性
クエリ、変換、データモデルから意味を抽出し、データの変化に合わせてセマンティックレイヤーを自己拡張型にすることで、基となるデータをカタログにコピーすることなく、セマンティックレイヤーの自己拡張を実現しています。Data StudioのAIエンリッチメントとデータ変換は、このアプローチを具体的に示しています。
Data StudioにおけるAIの強化

図9. AIエンリッチメントは、ユーザーが確認するための表と列の説明およびラベルを提案します。
Data StudioのAIエンリッチメント機能は、テーブルと列の説明を生成し、ラベルを提案することで、手作業を削減します。Oracle接続製品の例では、識別子、カテゴリ、コスト、価格などが網羅されています。ユーザーは保存前にコンテキストを確認し、必要に応じて修正できます。
データ変換パイプラインによるデータエンリッチメント
データ変換パイプラインは、スコープを説明するフィルタ、関係性を明らかにする結合、フィールドの由来を特定する変換を通じて、意味的なコンテキストを提供します。生成された注釈は、出力がどのように作成されたかを記述します。
図10のパイプラインは、PRODUCTSをCATEGORY = 'SOCCER'にフィルタリングしてSOCCER_PRODUCTSを作成します。図11の注釈は、このフィルタと変更されていない列のパススルーを記録しており、エージェントがサブセットを完全な製品カタログから区別するのに役立ちます。

図10. データ変換パイプラインはPRODUCTSをフィルタリングしてSOCCER_PRODUCTSを作成します。

図11. AI支援による注釈は、サブセットの状態と列の由来を捉えます。
ユーザーは、これらのAI生成アノテーションをデータ変換機能で確認・修正してから、意味的コンテキストとして再利用することができます。
要点:既存のOracleコンテキストとAIによるエンリッチメントにより、Oracleおよび非Oracleの資産全体で再利用可能なビジネス上の意味が提供され、発見とクエリ生成がサポートされます。
データ資産全体で意味定義を再利用する
ユーザーが独自の意味定義やモデルを持ち込めるようにしつつ、この豊富な意味情報を他のデータソースにも拡張するにはどうすればよいでしょうか?
Oracle AI Lakehouseは、テーブルデータにはApache Iceberg、データリネージにはOpenLineageといったオープンスタンダードを採用しています。セマンティックな相互運用性も同様のアプローチを採用しています。
私たちは、以前はOpen Semantic Interchange(OSI)として知られていたApache Ossie(インキュベーション段階)をサポートしています。これは、分析、AI、BIプラットフォーム間でセマンティックメタデータを交換するためのオープン仕様です。その共通表現には、データセット、フィールド、メトリクス、およびリレーションシップが含まれます(ossie.apache.org)。

図12.アナリティックビューとEssbaseのセマンティクスは、互換性のあるシステムで使用するために共通の形式で表現できる。
例えば、互換性のあるツールやエージェントは、クエリを作成する際に、アイスバーグテーブル内の対応する売上データにマッピングされた、確立済みの収益定義を適用できます。これにより、Oracleのセマンティックモデルを、重複したモデリング作業を減らしながら、より多くのデータに拡張できます。
私たちはApache Ossieに貢献し、サポートされているOracleのセマンティック定義を、他のソースのフィールドやリレーションシップにマッピングできる共通フォーマットで表現できるようにしています。ユーザーは、互換性のあるコンシューマーが再利用できるように、独自のデータセット、メトリック、およびリレーションシップを同じ表現で記述できます。
まとめ
AI-Catは、豊富なOracleセマンティクスを再利用し、自己拡張によってそれを拡張することで、レイクハウス全体でエージェントに共通のビジネスコンテキストを提供します。エージェントによるプルーニングは、このコンテキストを使用して検索を関連性の高い承認済みアセットに絞り込み、利用するエージェントがより少ないメタデータとトークンで、より迅速かつ効率的に作業できるように支援します。
より広範なプラットフォームのコンテキストについては、 「Oracle Autonomous AI Lakehouse のイノベーションを活用して、企業全体のデータ資産で AI エージェントをアクティブ化する」を参照してください。


コメント
コメントを投稿