エージェントのRAG: SQLcl MCPを介して既存のOracleベクトルを使用 (2026/10/02)
エージェントのRAG: SQLcl MCPを介して既存のOracleベクトルを使用 (2026/10/02)
SQLcl MCPサーバーには、context_retrieveClaude、Copilot、Codexなどのエージェントが応答する前にデータベースに関連する背景テキストを問い合わせることができる新しいツールが搭載されています。エージェントは短いキーワードクエリを送信します。SQLclはそれを構成済みのモデルに埋め込み、Oracle AI Databaseのベクトルテーブルに対してベクトル検索を実行し、最も一致する箇所をプレーンテキストとして返します。
この機能は、Oracle AI Database 26aiのベクターテーブルとその注釈に基づいて構築されています。この記事では、それらをすべて動作させる方法を説明します。
本日提供された優れた機能は、SQLcl 26.3とAutonomous Database 23.26.3を使用し、OCI Generative AI openai.text-embedding-3-large(3072次元)とMCPクライアントとしてClaude Codeを用いています。
この新しいMCPツールとは何ですか?
SQLclのMCPツール(context_retrieve)の説明では、エージェントに対し「ユーザーの生の入力から抽出した、簡潔でキーワードに焦点を当てた意味クエリ」を送信するように指示しています。エージェントは質問をキーワードに分解し、SQLclはそれらを埋め込みに変換し、データベースは最も近い保存済みの文章を検索します。
その結果、検索拡張型生成(RAG)が実現します。この場合、知識ベースはOracleデータベース内のベクトルテーブルとして表現されます。エージェントは、いつそのテーブルを呼び出すかを決定します。
このトピックが以前の記事と似ていると感じられた方は、いつも読んでいただきありがとうございます!今回の新しい内容は、DMBS_VECTOR_DATABASE パッケージを使用して正式に「ベクター テーブル」を作成および管理し、この特定の MCP ツールと組み合わせて「RAG を実行する」ことです。以前は、リレーショナル テーブル内の既存のベクターを SQL および run-sql ツールと組み合わせて使用する方法をご紹介していました。
前回までのthatjeffsmithの記事…
前提条件
- データベース: Oracle AI Database
DBMS_VECTOR_DATABASE(VecDB)。ADB 23.26.3 でテストしました。ツールはDBMS_VECTOR_DATABASE.LIST_VECTOR_TABLESとを呼び出しますDESCRIBE_VECTOR_TABLE。 - SQLcl 26.3以降:
context_retrieveツールが含まれています - OCI生成AI構成済み埋め込みモデル
- 保存された接続。私はOCIデータベースツールの接続を使用しましたが、必須ではありません。ただ、より簡単です。

SQLclとOCI生成AI/埋め込みモデルの設定
SQLclは、類似性検索の一環として、入力文字列をデータベースに送信する前に、OCIの埋め込みモデルを呼び出してベクトル化します。
SQLclには、この設定を行うための新しいコマンドがあります model。これを使用するには、以前に説明したOCIプロファイルを構成する必要があります。
しかし、まずは、利用可能な埋め込みモデルを参照する場所のコンパートメントIDを知る必要があります。
SQL> model config embedding-model -model-name openai.text-embedding-3-large -serving-type ON-DEMAND -compartment-id ocid1.tenancy.oc1..aaaaaaaabcdefghijklmnopqrstuvwxzySQLcl が埋め込みモデルを使用する準備が整い、すべて問題ないことを確認するには (LLM もサポートされていますが、この機能には適用されません)、 を使用できますmodel config -list。
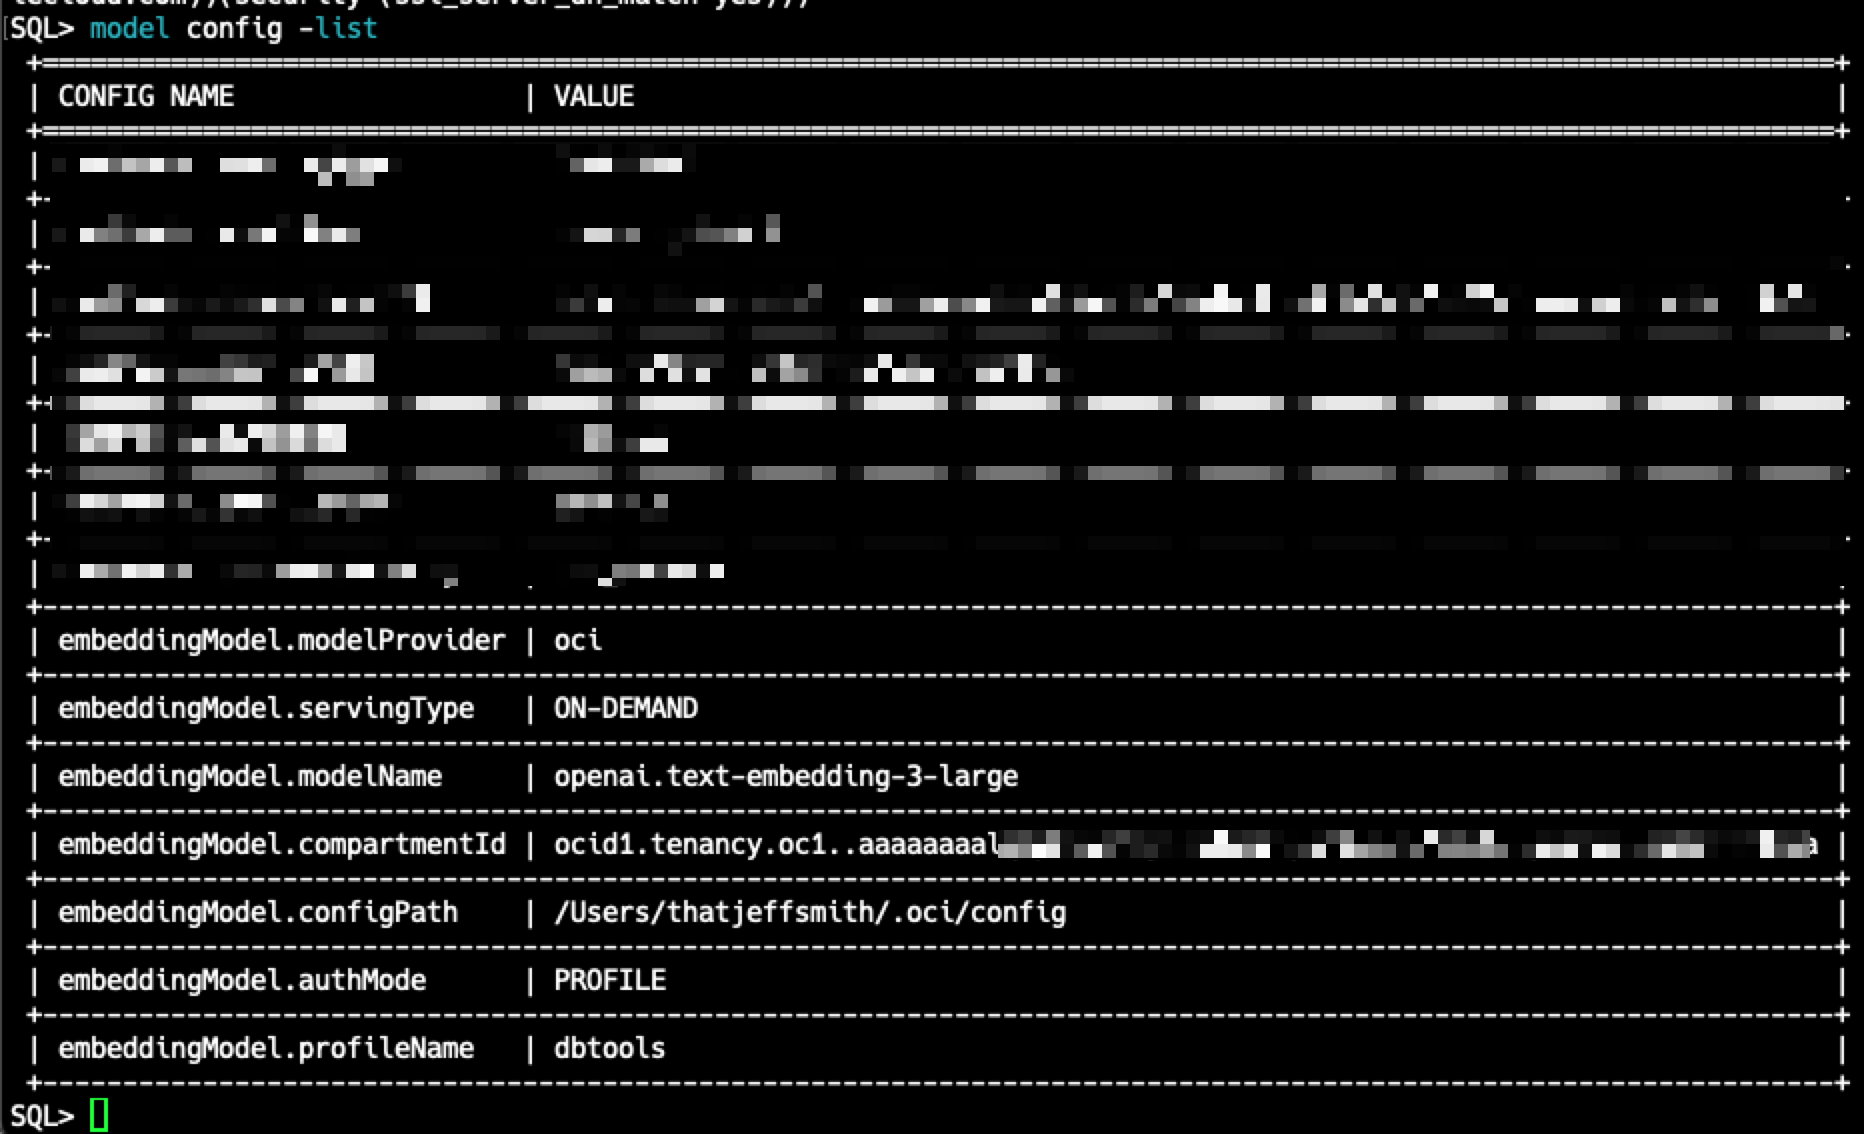
これらの設定を手動で調整する必要がある場合は、SQLcl アプリケーションの設定が保存されている場所に保存されます。Mac または Linux の場合は、 となり$HOME/.dbtools/sqlcl、ファイルは ですmodel_config.json。
仕組み
エージェントは既にSQLを理解しており、SQLcl MCPサーバーを使用してスキーマを参照し、クエリを実行できます。エージェントが知らないのは、チームの運用マニュアル、「いつもこうやっています」という決定事項、2年前に誰かが見つけた修正方法など、あなたのschema_information知識です。は、エージェントにテーブルの構造を伝えます。 は、エージェントにcontext_retrieveあなたのチームの知識を伝えます。
現実世界の例
DBAチームがランブックとインシデント報告書をベクトルテーブルに保存しているとします。各段落は埋め込みを含む短いテキストの塊です。ある夜、データウェアハウスのロードが失敗し、チームの誰かがエージェントに問い合わせました。
「夜間のロード処理でまたORA-01652エラーが発生してしまいました。通常、このような場合どう対処するのでしょうか?」
次のようなことが起こります。
- エージェントは背景情報が必要だと判断します。質問は「通常何をするか」に関するもので、スキーマからは判断できません。エージェントは context_retrieveを呼び出します。
- エージェントは、ツールの説明にあるように、質問をキーワードに凝縮します
ORA-01652 temp tablespace nightly load runbook。 - SQLcl は、キーワードを埋め込み、該当するベクター テーブルを検索し、最も近い箇所をテキストとして返します。例えば、「夜間ロードの大きなソート処理が TEMP にスピルします。TEMP のサイズを変更するのではなく、TEMP_BATCH に一時ファイルを追加し、まず並列セッションの暴走をチェックしてください。」といった具合です。
- エージェントは発見した情報に基づいて行動します。エージェント
TEMP_BATCHは並列セッションを監視する必要があることを認識し、それを使用してsql_run現在のTEMP使用量とアクティブなセッションを確認します。 - その回答は根拠に基づいています。ユーザーは、ORA-01652に関する一般的なアドバイスではなく、稼働中のデータベースで検証されたチーム独自の手順を受け取ることができます。
ユーザーはテーブル名を入力したり、ベクトル検索を要求したりしたことは一度もありません。エージェントが取得のタイミングを決定し、データベースが関連性を判断し、エージェントが両者を組み合わせて処理しました。
ツール内部では何が起こるのか
agent --"SQLcl MCP logging audit LLM"--> context_retrieve
   1. embed the query with embeddingModel (3072-dim)
   2. LIST_VECTOR_TABLES()  ->  every VecDB table you can see
   3. keep only tables whose annotations match:
        purpose           = sqlcl-rag
        model_fingerprint = <embeddingModel.modelName>
        vector_dimension  = <model's dimension>
   4. vector search each matching table (top 7, min score 0.7)
   5. return each hit's metadata "text", one per line
ステップ3では、いわゆる「魔法」の一部がどこにエンコードされているかを示します。特定の注釈値を持つVectorDBテーブルを利用して、MCPサーバーに適切な情報を見つける場所を指示します。
ジェフ、VectorDBって何?Vector Tablesって何?Oracleは統合型だと思ってたんだけど?
私たちは新しい用語を作るのが好きなんです、はは。でも真面目な話、ここで精一杯頑張ってみます。
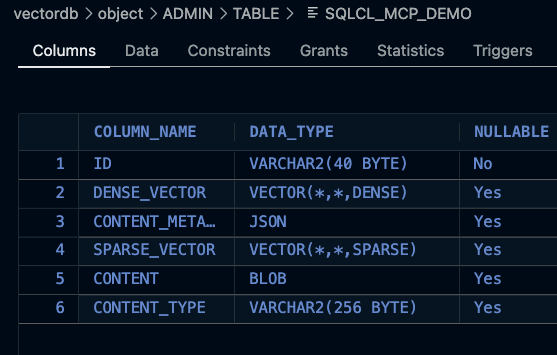
- VectorDBまたはVecDB:26ai に組み込まれている PL/SQL パッケージ DBMS_VECTOR_DATABASE の機能です。データベースでベクトルを使用する場合でも、必ずしもこの PL/SQL インターフェースを使用する必要はありません。
- ベクターテーブル:主に前述のDBMS_VECTOR_DATABASEを使用して作成されたテーブルです。また、(私の理解では)ベクター列を持つリレーショナルテーブルをこのエコシステムに接続することもできるので、両方の利点を享受できます。VecDB
のドキュメントを参照してください。
注釈を通して「魔法」を起こす
当然の疑問として、エージェントは何をpurpose送ればよいかをどのように判断するのか、という点が挙げられます。エージェントは何も送信しません。ツールはキーワードクエリ(監査ログ用のLLM名も含む)のみを受け取ります。注釈はテーブルを作成する人が一度設定し、SQLclは呼び出しごとに自動的にチェックします。
| 注釈 | 設定者 | SQLcl はそれを比較します |
|---|---|---|
purpose | テーブルオーナー | 固定値sqlcl-rag |
model_fingerprint | テーブルオーナー | embeddingModel.modelNameでmodel_config.json |
vector_dimension | テーブルオーナー | 埋め込みモデルの次元 |
つまり、注釈はルーティングラベルではなくゲートとして機能し、そのゲートには2つの目的があります。
 オプトイン方式を採用しています。スキーマには、人事関連文書や顧客データなど、エージェントのコンテキストに取り込まれたくないベクターテーブルが含まれている場合があります。
sqlcl-rag検索対象となるのは、ユーザーが意図的にマークしたテーブルのみです。- モデルの安全性。あるモデルで埋め込まれたクエリは、別のモデルで作成されたベクトルと意味のある比較はできません。また、異なる次元のベクトルは全く比較できません。フィンガープリントと次元のチェックにより、クエリと格納されたベクトルが同じモデルから生成されたものであることが保証されます。テーブル自体はこのことを強制できません。VecDBは固定次元を持たない
DENSE_VECTORプレーンな列として作成するVECTORため、どのモデルからのベクトルでも受け入れます。注釈は、どのモデルがベクトルを生成したかを示す唯一の記録です。
考慮すべき結果の一つとして、エージェントはどのテーブルを検索すべきか分からないという点が挙げられます。スキーマにsqlcl-ragアノテーションが付いているすべての対象テーブルが呼び出しごとに検索され、それらすべてから最適なパッセージがまとめて返されます。
 例えば、DBAの運用マニュアルとマーケティングに関するFAQなど、個別のナレッジベースを分けて管理したい場合は、当面はそれぞれ異なるスキーマまたはデータベースに保存してください。
ベクトルテーブルの準備
自己申告型か、それともモデルベース型か?
DBMS_VECTOR_DATABASE2種類のベクターテーブルを作成します。
- 独自のベクトルを持ち込む (BYOV):埋め込みを計算して渡します。これは、 を省略した場合に得られるものです
embed_params。 - モデルベース:ユーザーがデータを提供する
embed_paramsと、データベースは読み込み時に各行のメタデータ内のテキストフィールドから埋め込みを生成します。
context_retrieveSQLcl にクエリ自体を埋め込み、ベクトルで検索します。つまり、このツールは BYOV 方式で動作します。私が使用したのもそれです。埋め込みは、で設定されているのと同じ OCI モデルによって生成されますmodel_config.json。
ここでは最初の方法(BYOV)のみを説明します。BYOVテーブルをcontext_retrieve使用するには、テーブルに適切な注釈がtext付いていることと、各行のメタデータにあるキーの下の文章テキストの2つが必要です。
ステップ1:表に注釈を付ける
既にベクターテーブルをお持ちの場合は、再構築する必要はありません。UPDATE_VECTOR_TABLE_ANNOTATIONデータには手を加えずにテーブルのメタデータを変更します。
declare
  r clob;
begin
  r := dbms_vector_database.update_vector_table_annotation(
         name        => 'MY_VECTORS',
         annotations => json('{
           "purpose"           : "sqlcl-rag",
           "model_fingerprint" : "openai.text-embedding-3-large",
           "vector_dimension"  : "3072"
         }'));
end;
/新しいテーブルを作成しますか?同じ注釈を次のテーブルに渡してくださいCREATE_VECTOR_TABLE。
declare
  r clob;
begin
  r := dbms_vector_database.create_vector_table(
         name        => 'MY_VECTORS',
         comment     => 'Team runbooks for context_retrieve',
         annotations => json('{
           "purpose"           : "sqlcl-rag",
           "model_fingerprint" : "openai.text-embedding-3-large",
           "vector_dimension"  : "3072"
         }'));
end;
/purpose、model_fingerprintおよびはチェックされるvector_dimension3つです。SQLclがテーブルを作成する際に、、およびも追加されますが、これらをチェックするものはありません。embedding_sourceembedding_providerchunking_strategy- OCIモデルの場合、
model_fingerprintは単にembeddingModel.modelNameからmodel_config.json取得されます。モデルを変更すると、古いテーブルは一致しなくなります。これは意図的なものであり、異なるモデルのベクトルは比較できないためです。
確認してみてください:
select json_query(dbms_vector_database.list_vector_tables,
         '$.vector_tables[*]?(@.table_name == "MY_VECTORS").annotations'
         with wrapper) ann
from dual;3つのキーがすべて表示されているはずです。もし1つvector_dimensionでも欠けている場合は、数値として入力されています。
textステップ2:メタデータキーに文章テキストを入力する
このリトリーバーはlangchain4jのOracle VecDBストア上に構築されており、各パッセージをから読み取りますmetadata.text。このキーがないと、ツールはで失敗しますtextSegment cannot be null。
新しい行を読み込むときは、textメタデータに、やなどUPSERT_VECTORSの他の必要なフィールドとともに書き込みます。topicsource
declare
  r clob;
begin
  r := dbms_vector_database.upsert_vectors(
         table_name => 'MY_VECTORS',
         vectors    => json('[
           { "id"           : "1",
             "dense_vector" : [ ... 3072 numbers from your embedding model ... ],
             "metadata"     : { "text"  : "Every statement the SQLcl MCP server runs is logged to DBTOOLS$MCP_LOG.",
                                "topic" : "sqlcl" } }
         ]'));
end;
/
行に既に別のキーでパッセージが格納されている場合は、それを にコピーしてくださいtext。私のデモ行では以下を使用しましたcontent。
update my_vectors
   set content_metadata = json_transform(
         content_metadata,
         set '$.text' = json_value(content_metadata, '$.content' returning varchar2(4000)));
デモ
私の表には8つの段落があります。そのうち7つはSQLcl/ORDSに関するヒント、1つは意図的なミスリード(適合性)です。
クエリ: SQLcl MCP server logging audit LLM statements
Every statement the SQLcl MCP server runs is logged to the DBTOOLS$MCP_LOG table and tagged with a comment naming the LLM in use.
Start the SQLcl MCP server with sql -mcp; AI clients like Claude Code then get tools such as connect, sql_run, sqlcl_run and schema_information.
SQLcl saves named connections with conn -save name -savepwd user/password@host:port/service, and the SQLcl MCP server can only use saved connections.
SQLcl supports Liquibase with the lb or liquibase command for generating and deploying database changelogs in CI/CD pipelines.
正解が先です。フィットネスの行程はカットオフ値を下回っています。
クエリ: ORDS REST enable table
ORDS AutoREST lets you REST enable a table or view with ORDS.ENABLE_OBJECT, instantly exposing GET, POST, PUT and DELETE endpoints.
ORDS can secure REST APIs with OAuth2 client credentials, roles and privileges defined via the ORDS_SECURITY and ORDS packages.
クエリ: recovery workout
A good recovery day workout is an easy 30 minute zone 2 bike ride followed by mobility and stretching.ここには妨害要素だけが戻ってきて、SQLcl の行はどれも戻ってきません。
クエリ: quantum chromodynamics gluon
No retrieval context found: matched embedding tables returned zero results.
matchedTables=[SQLCL_MCP_DEMO2]. Try a more focused userInput.
関連する結果は見つからなかったため、ツールは弱い一致を返す代わりにその旨を報告します。これはRAGに期待される動作です。
エージェント/データベースでは、これはどのように表示されますか?
私が質問し、私のエージェントがMCPツールを呼び出し、その応答が返ってきた。
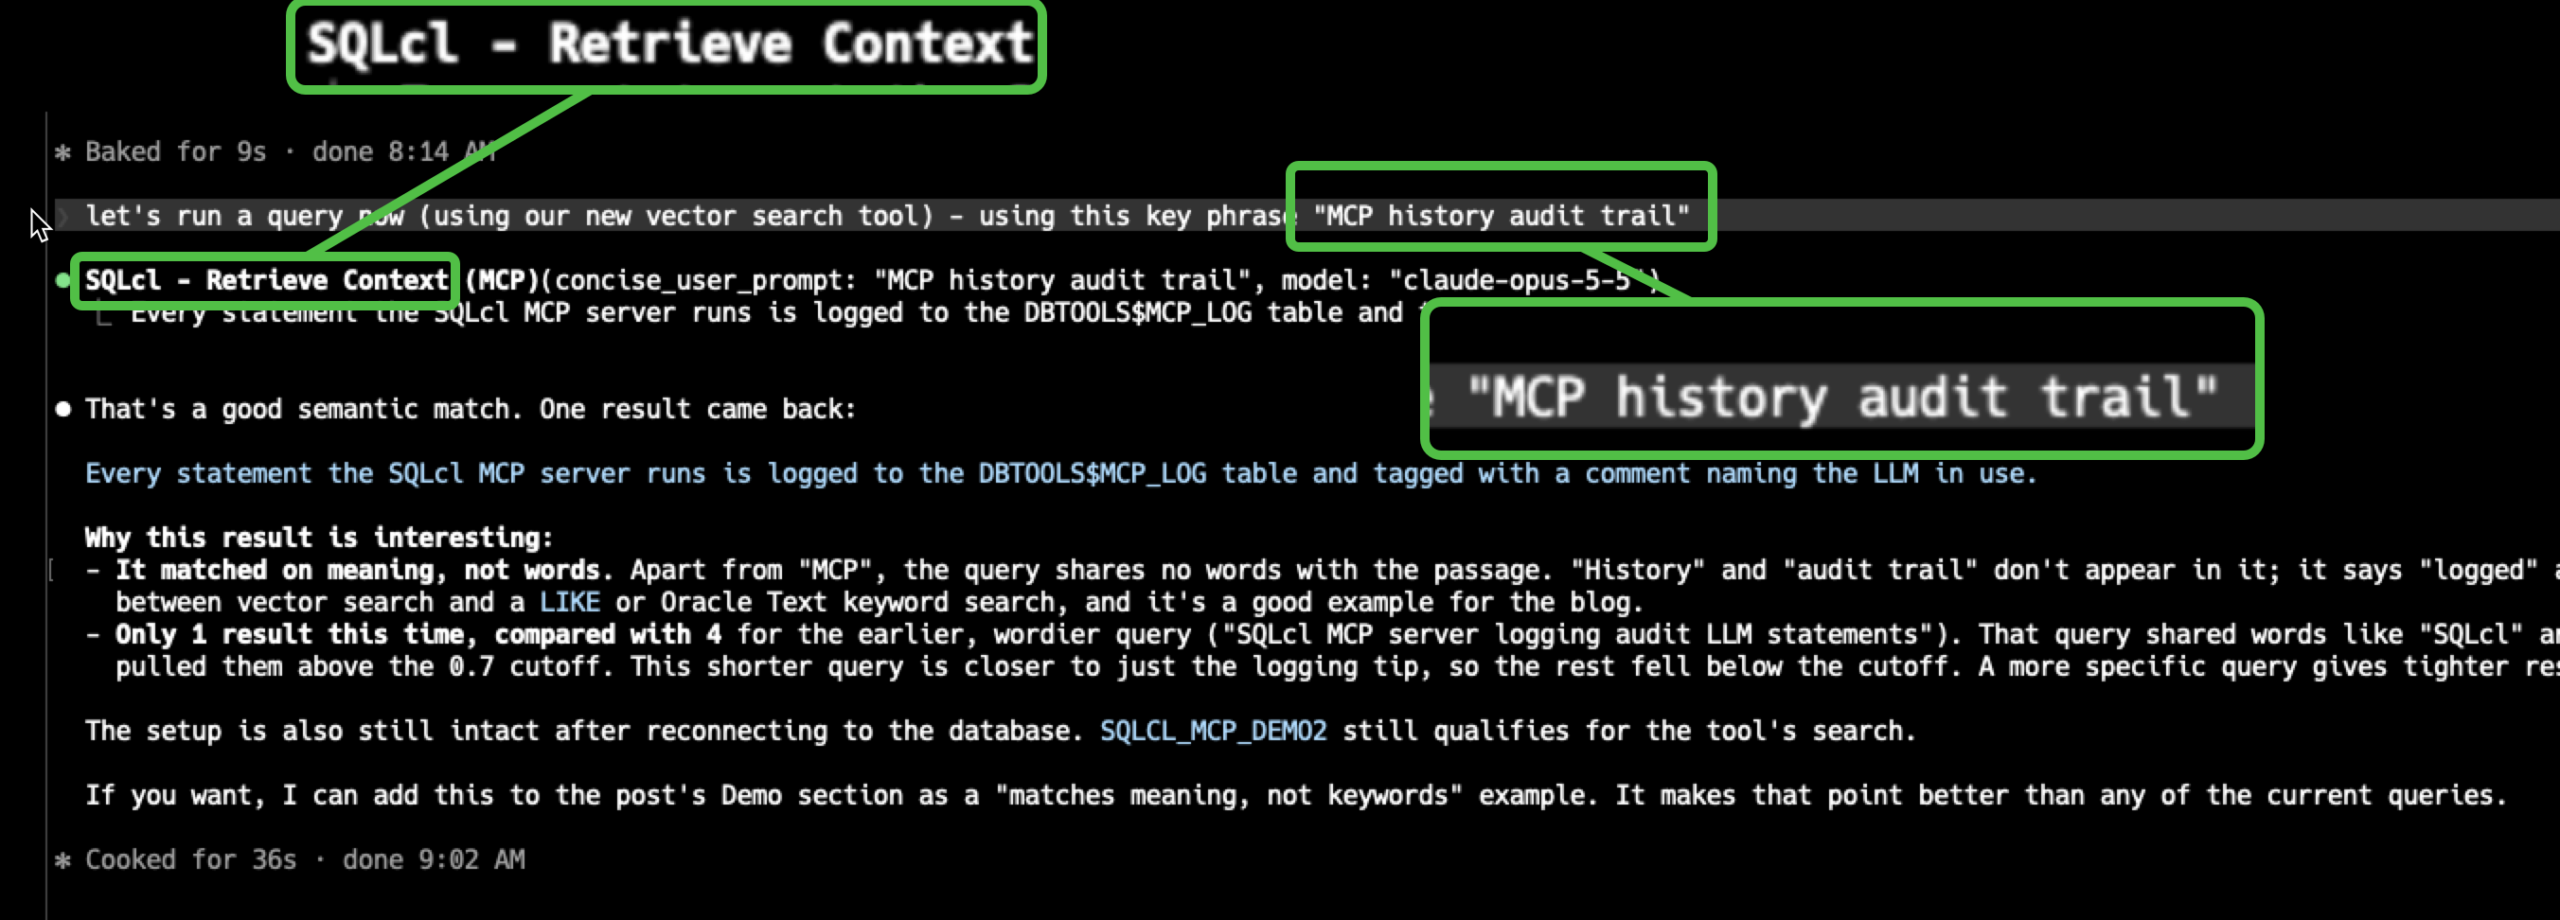
そして、その回答の基となったVecDBテーブルの対応する行は次のとおりです。
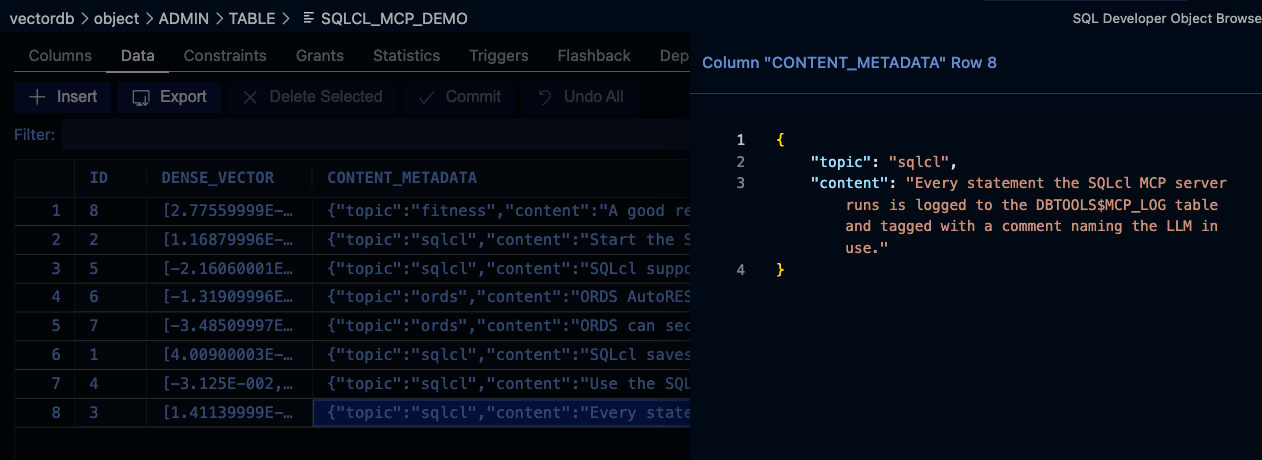
返ってくるもの
- プレーンテキスト、1行に1つの文章、最も一致するものが最初に表示されます。
- スコア、ID、メタデータフィールド、テーブル名などは一切ありません。エージェントは、その回線がどこから来たのかを判別できません。
- マッチングテーブルごとに最大7件の結果が表示され、スコアが0.7以上のヒットのみが表示されます。これらの値は両方ともハードコードされています。
- 各呼び出しは
DBTOOLS$MCP_LOGとしてログに記録されますcontext retrieval executed: matchedTables=N, results=M。クエリテキストはログに記録されません。
トラブルシューティング
| あなたが見るもの | それはどういう意味か | 修理 |
|---|---|---|
no embedding tables matched the active embedding model fingerprint. configuredTables=[] ... Verify ... DBTOOLS$EMBEDDING_TABLES metadata | 適切な注釈を持つ VecDB テーブルが存在しません。DBTOOLS$EMBEDDING_TABLES存在しないため、使用されていません。 | purpose、model_fingerprintおよび注釈をすべて文字列として追加しますvector_dimension(ステップ 1)。 |
textSegment cannot be null | テーブルが一致し、検索でヒットが見つかりましたが、ヒットには がありませんmetadata.text。 | text(手順2)該当する箇所を凡例の下に配置してください。 |
matched embedding tables returned zero results | 0.7点以上を獲得したものは一つもなかった。 | 別のキーワードを試してみてください。そうしないと、関連する情報が見つからない可能性があります。 |
まとめ!
Oracle 26aiデータベースは非常に強力なVECTORインターフェースを備えており、類似性検索やRAGパイプラインの導入を格段に容易にします。
SQLcl MCP は、新しいツールを使用してエージェントがこの情報に簡単にアクセスできるようにしますcontext_retrieve。
リリースノート、社内運用マニュアル、サポート回答、自社ブログ記事など、いつでも利用できるナレッジベースとして活用してください。
トピックまたはコーパスごとに1つのテーブルを保持してください。アクティブなモデル用に注釈が付けられたすべてのテーブルは、呼び出しのたびに検索されます。


コメント
コメントを投稿