永続アプリケーション・メモリーに対するOracle AI DatabaseでのMem0 Pythonの使用 (2026/11/09)
永続アプリケーション・メモリーに対するOracle AI DatabaseでのMem0 Pythonの使用 (2026/11/09)
投稿者:Srinidhi Sathyamurthy | AI Developer Advocate
Oracle AI Databaseをベクトルストアとして使用して、Mem0メモリを保存、検索、フィルタリング、更新、削除、および検査するための実践的な開発者ガイド。
補足ノートブック: Mem0 PythonメモリとOracle AIデータベース
主なポイント
有用なアプリケーションメモリ層には、埋め込みデータを格納する場所以上のものが必要です。メモリレコードを保存し、適切なレコードを取得し、アプリケーションコンテキストに基づいてフィルタリングし、事実が変更されたときに更新し、不要になったときに削除する方法が必要です。
この記事では、開発者が直面する問題点を取り上げます。目的は、メモリという概念について包括的に解説する記事を書くことではありません。目的は、Mem0 PythonがOracle AI Databaseを永続的なアプリケーションメモリのバックエンドストレージとしてどのように利用できるかを示すことです。
Mem0はPythonのメモリAPIを提供します。Oracle AI Databaseは、耐久性のあるベクトルベースのストレージレイヤーを提供します。Oracleのoracledbプロバイダは両者を接続するため、Pythonアプリケーションはメモリの追加、後からの検索、JSONペイロードメタデータによるフィルタリング、レコードの更新と削除、および永続化されたデータの検査を行うことができます。
付属のノートブックでは、2人のサンプルユーザー、1人のサンプルエージェント、いくつかの明示的なメモリ、メタデータカテゴリ、更新および削除操作、そしてOracleへの直接的な検査を使用しています。これにより、チュートリアルを本格的なチャットボット実装にすることなく、ストレージパスを可視化できます。
本稿におけるアプリケーションメモリとは、アプリケーションが複数のリクエストにわたって利用できる、構造化された取得可能なコンテキストを意味します。これはチャット履歴とは異なります。チャット履歴はメッセージのシーケンスです。アプリケーションメモリは、検索、スコープ設定、更新、削除が可能な、管理された記録です。
その区別が重要なのは、ほとんどのアプリケーションは過去のメッセージすべてを必要としないからだ。必要なのは、適切な情報を適切なタイミングで入手することである。
アプリケーションメモリを理解する良い方法は、3つの役割を持つ小さなレコードとして考えることです。アプリケーションが後で必要とする可能性のある事実を格納し、その事実が適切なユーザー、エージェント、またはワークフローに属するようにスコープを保持し、推測せずに検索を絞り込めるようにメタデータを保持します。ベクトルは類似の意味を見つけるのに役立ちます。ペイロードはアプリケーションが制御を維持するのに役立ちます。
開発者パターン
仕組みは単純明快です。PythonアプリケーションがMem0を呼び出します。Mem0はメモリレコードを作成または受信します。Oracleプロバイダは、各メモリをOracleテーブルの行として格納します。埋め込み情報はベクトル列に、メモリテキストとメタデータはJSONペイロードに格納されます。ベクトルは類似性を確認するためのものです。JSONペイロードは、アプリケーションのコンテキスト情報とデバッグ情報として使用されます。
アプリケーションには両方が必要です。類似性によって、クエリに近い意味を持つレコードを見つけることができます。ペイロードは、レコードをユーザーID、エージェントID、カテゴリ、ソース、およびアプリケーションが推論できるその他のフィールドに関連付けます。
その後、アプリケーションはMem0 APIを介してそのテーブルを検索し、返されたメモリをコンテキストとして使用します。
この方法は、メモリ操作とモデル呼び出しを分離できるため便利です。アプリケーションは、プロンプトに以前のメッセージをすべて保持する必要がありません。スコープを絞ったレコードセットを取得し、必要なコンテキストのみを次のステップに渡すことができます。これにより、プロンプトのノイズも軽減されます。長いトランスクリプトを送信してモデルが有用な部分を見つけてくれることを期待するのではなく、アプリケーションはスコープとメタデータフィルタを既に通過した、より小さなメモリレコードセットを取得します。
同じパターンは、さまざまな種類のアプリケーションに適用できます。カスタマーサポートアシスタントは、過去のケースのコンテキストを記憶できます。コーディングアシスタントは、プロジェクトの規約を記憶できます。レコメンデーションワークフローは、ユーザーの好みを記憶できます。REST APIは、モデルを呼び出したり、レスポンスを組み立てたりする前に、関連するメモリ情報を取得できます。
メモリ層がプロンプトの外側に配置されるべき理由もここにあります。プロンプトは即時的なコンテキストを提供するには便利ですが、永続的な記録システムではありません。データベースを基盤としたメモリ層は、アプリケーションが再利用可能なコンテキストを保持し、そのコンテキストがリクエストに関与すべきタイミングを判断できる場所を提供します。
アーキテクチャ
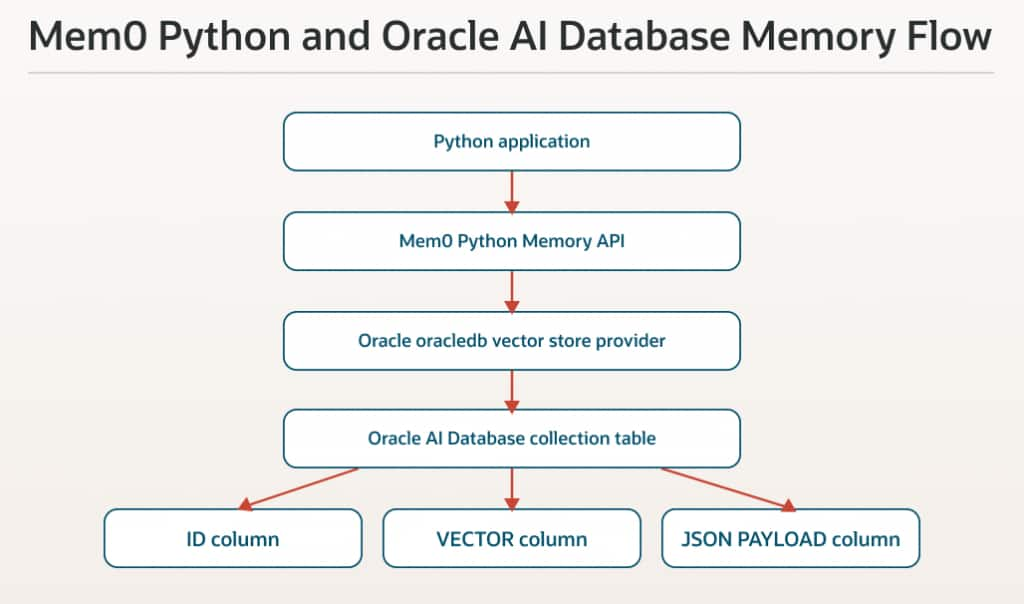
このアーキテクチャは4つの構成要素から成り立っています。Pythonアプリケーションはユーザーリクエストとアプリケーションルールを管理します。Mem0はメモリAPIを管理します。Oracleのoracledbプロバイダは、Mem0のベクトルストア操作をOracle AI Databaseにマッピングします。Oracleは、ベクトル列とJSONペイロードを含む永続テーブルを保存します。
アプリケーションコードは、すべての操作に対してベクトルSQLを直接記述する必要はありません。追加、検索、更新、削除などのMem0メソッドを使用します。同時に、ストレージはOracle上で可視化されているため、開発者はデバッグ時に行、ペイロード、およびカウントを検査できます。
このノートブックは、このアーキテクチャをローカルかつ再現可能な形で維持します。環境から接続値を読み込み、Mem0構成を作成し、サンプルメモリを書き込み、スコープ付き取得を実行し、最後にOracleテーブルをチェックします。各ステップは理解しやすいほど小さいですが、それらを合わせると実際のアプリケーションパスが示されます。
概念的には、2つの検索ステップが同時に実行されます。ベクトル比較では、クエリと意味的に近いレコードが検索されます。構造化フィルタは、そもそもどのレコードを考慮に入れるかを決定します。どちらのステップも重要です。スコープを考慮しない類似性では、ユーザーのコンテキストが誤って返される可能性があります。類似性を考慮しないスコープでは、データが多すぎる可能性があります。
検索範囲は、メモリシステムにおける最初の関連性の境界です。メモリが意味的に関連性があるかどうかを問う前に、アプリケーションは検索範囲を現在のユーザー、エージェント、テナント、プロジェクト、またはワークフローに属するレコードに絞り込む必要があります。
ノートブックでは、主な取得範囲はuser_idです。エージェントの例ではagent_idを使用しています。実際のアプリケーションでは、取得範囲にはユーザーID、テナントID、エージェントID、プロジェクトID、ワークフローIDなどが含まれる場合があります。これらのフィルタは関連するメモリセットを選択するのに役立ちますが、アプリケーションレベルの認証は引き続き周囲のアプリケーションによって処理される必要があります。
Mem0をOracle AI Databaseで構成する
最初の重要なステップは、Mem0 の設定です。ベクターストアプロバイダは oracledb に設定されています。コレクション名は、メモリ収集に使用される Oracle テーブルにマッピングされます。接続パラメータは、ハードコードされた秘密情報ではなく、ノートブック環境から取得されます。
from mem0 import Memory

config = {
    "vector_store": {
        "provider": "oracledb",
        "config": {
            "collection_name": "MEM0_PY_MEMORY_DEMO",
            "embedding_model_dims": 32,
            "connection_params": {
                "user": ORACLE_USER,
                "password": ORACLE_PASSWORD,
                "dsn": ORACLE_DSN,
            },
            "distance_metric": "COSINE",
            "do_create_index": False,
        },
    },
}

memory = Memory.from_config(config)
この構成は、Mem0とOracle AI Database間の契約です。Mem0は、使用するベクトルストアプロバイダ、Oracleへの接続方法、書き込み先のコレクション、および各埋め込みベクトルのサイズを把握する必要があります。これらの値が間違っている場合、メモリAPIは単純に見えるかもしれませんが、ストレージパスは失敗します。
重要なルールは、Mem0構成における埋め込み次元が埋め込みモデルと一致している必要があるということです。モデルが1536次元ベクトルを返す場合は、1536を使用します。別の次元を返す場合は、その値を設定します。ここで不一致があると、ストレージパスが破損します。
このノートブックは決定論的なローカル埋め込み機能を使用しているため、外部モデルクレジットなしでチュートリアルを実行できます。本番環境でも同様の構成パターンが適用されますが、埋め込みプロバイダとディメンションは、その環境で承認されているプロバイダと一致させる必要があります。
スコープ付きメモリを追加する
このチュートリアルでは、2人のサンプルユーザーに対して明示的なメモリを追加します。レコードは同じOracleコレクション内に存在しますが、各メモリにはユーザーIDが付与されます。このユーザーIDは、後ほど検索フィルタの一部として使用されます。
このスコープこそが、この例が単なる汎用的なベクトル検索デモではなく、アプリケーションのメモリ管理を体現しているように感じられる最初の要素です。実際のアプリケーションでは、メモリを適切なユーザー、エージェント、テナント、アカウント、またはワークフローに紐づけておく必要があります。
memory.add(
    "User A prefers vegetarian pasta for weekday dinners.",
    user_id="user_a",
    metadata={"category": "food", "source": "profile"},
    infer=False,
)
このノートブックは を使用しますinfer=False。つまり、Mem0 は指定されたテキストをメモリに直接格納します。これにより、例の予測可能性が高まり、出力の検証が容易になります。
ここには設計上の選択肢も存在します。明示的なメモリは、アプリケーションが保存する内容を正確に決定できるため、テストが容易です。推論されたメモリは、自然な会話から抽出できるため、より柔軟性があります。ほとんどの運用システムでは、最終的には、明示的なアプリケーション情報を保存するタイミングと、モデルにメモリを提案させるタイミングの両方についてポリシーが必要になります。
別の用途では、Mem0 が会話メッセージからメモリを推論するようにしたい場合もあるでしょう。これは有効な方法ですが、抽出ステップが導入され、通常はモデルへの依存性が生じます。
この分離は、実際のアプリケーションを設計する際に役立ちます。まず、明示的なメモリへの書き込み、取得、更新、削除が可能であることを確認します。ストレージパスが信頼できることが確認できたら、製品が必要とする抽出ロジックを追加します。こうすることで、ストレージの問題と抽出の問題が最初から混在しないため、障害の診断が容易になります。
ユーザー範囲とメタデータによる検索
ノートブックがメモリを追加した後、ユーザーAに関連するレコードを検索します。フィルターによって、検索対象が正しいユーザーの範囲内に留まります。これは、コレクションに複数のユーザーのレコードが含まれる可能性があるため重要です。
ワークフローはメタデータによってフィルタリングされます。メタデータは、アプリケーションコンテキストが役立つ部分です。カテゴリ、ソース、テナント、製品、エージェントID、ワークフロー名、保持クラスなどはすべて、取得制御として使用できます。
movie_results = memory.search(
    "What movies does this user like?",
    top_k=5,
    filters={
        "user_id": "user_a",
        "category": "movie",
    },
)
ノートブックの出力には、ユーザーAに関する映画関連の記憶が1つ表示されています。これが重要な点です。アプリケーションは、テーブル全体にわたって類似したテキストを要求しているわけではありません。適切な範囲とカテゴリ内の有用な記憶を要求しているのです。
メタデータによるフィルタリングは、検索動作の説明を容易にします。検索結果が表示された場合、開発者はどのフィルタによって結果が表示されたのかを確認できます。結果が表示されない場合は、保存されているペイロードを調べて、想定されたスコープまたはカテゴリで保存されたかどうかを確認できます。
ほとんどのアプリケーションメモリでは、純粋なセマンティック検索だけでは不十分です。通常は、セマンティック検索に加えて、アプリケーションドメインから提供されるフィルタが必要になります。Mem0はPython APIを提供します。Oracleは、これらのフィルタが使用するベクトルとJSONペイロードを格納します。
これにより、アプリケーションの理解も容易になります。本来表示されるべきでない結果が表示された場合、開発者はクエリ、フィルタ、および保存されたペイロードを確認できます。結果が表示されない場合は、メモリが想定されるユーザーIDとカテゴリの下に保存されているかどうかを確認できます。
より広い意味で言えば、メタデータはメモリをアプリケーション機能に変えるものだ。サポートツールはアカウントIDと製品分野でフィルタリングできる。コーディングアシスタントはリポジトリとブランチでフィルタリングできる。ワークフローエンジンは実行IDとタスクタイプでフィルタリングできる。フィールドは異なるが、パターンは同じだ。
エージェントスコープのメモリを追加する
このノートブックでは、エージェントスコープのメモリも1つ追加されています。これはユーザーAとユーザーBとは別個のものです。メモリはuser_idではなくagent_idで保存されます。
これは、すべてのメモリがエンドユーザーに属するわけではないため重要です。一部のメモリは、アシスタント、ワークフロー、サポートボット、またはエージェントランタイムに属します。たとえば、アプリケーションは、サポートエージェントに、取得したメモリを要約して次のアクションを提案する方法などの操作手順を記憶させたい場合があります。
agent_id = "support_agent"

memory.add(
    "Support agent should summarize retrieved memories before suggesting the next action.",
    agent_id=agent_id,
    metadata={"category": "agent_instruction", "source": "system"},
    infer=False,
)

agent_results = memory.search(
    "How should the support agent use retrieved memories?",
    top_k=3,
    filters={"agent_id": agent_id},
)
この手順により、チュートリアルを必要以上に複雑にすることなく、実用的な内容を維持できます。また、適切なフィルタを使用してアプリケーションが検索を行う限り、同じOracleベースのコレクションでも異なるスコープを持つことができることを示します。
本番環境では、このパターンはrun_id、テナントID、プロジェクトID、アカウントID、またはアプリケーションが必要とするその他のスコープフィールドにも拡張できます。重要なルールは、明示的に指定することです。メモリ層は、リクエストに対してどのレコードが許可されているかを推測すべきではありません。
メモリを考慮した回答を作成する
このノートブックは、最終的な応答をハードコーディングするのではなく、取得したメモリからメモリを考慮した小さな応答を生成します。これは、処理の流れをより正直に示すことができるため、有益な変更です。
このアプリケーションは、質問を投げかけ、ユーザーAの記憶を取得し、カテゴリ別にグループ化し、取得した情報に基づいて回答を作成します。これはまだチュートリアル段階の回答であり、完全なチャットボットではありませんが、重要なアプリケーションステップ、つまり回答が取得された記憶記録に基づいていることを証明しています。
このノートブックは、ユーザーAの食べ物、映画、旅行に関する記憶を取得し、取得した行を夕食と映画の提案に変換します。出力には使用された記憶が含まれ、応答ソースはセル内の取得されたMem0記憶から生成されたものとしてラベル付けされます。
メモリレコードの更新と削除
メモリにはライフサイクル管理が必要です。メモリは自動的に真実となるわけではありません。それはアプリケーションの状態です。他の状態と同様に、古くなったり、重複したり、不完全になったり、間違っていたりする可能性があります。更新と削除の操作によって、メモリが古い仮定の山と化すのを防ぐことができます。
記録の内容がより詳細になる場合がある。設定が変わる場合がある。ユーザーが削除を要求する場合がある。ワークフローによって、古いメモリは検索対象から除外されると判断される場合がある。
このノートブックは、ユーザーAの映画設定を1つ更新し、ユーザーBの食べ物設定を1つ削除します。これらは小さな操作ですが、メモリ層が追記専用ではないことを証明しています。
memory.update(
    movie_memory_id,
    text="User A likes optimistic science fiction movies about space exploration.",
    metadata={"category": "movie", "source": "updated_chat"},
)

memory.delete(user_b_food_id)
アップデート後、映画検索では修正されたメモリテキストが返されます。削除後、ユーザーBの検索結果は2件から1件に減少します。これらのチェックは単純ですが、開発者が大規模なアプリケーションでパターンを信頼する前に必ず確認したいチェックです。
本番環境では、更新と削除に関するポリシーがより厳格になる場合があります。一部のレコードはバージョン管理が必要になるかもしれません。一部の削除は保持ルールに基づいて行われるかもしれません。一部の更新はレビューが必要になるかもしれません。このノートブックでは、これらのポリシーの基盤となる基本的な操作について説明します。
ライフサイクル管理は、メモリが古くなる可能性があるため、特に重要です。保存された設定は、それが有効な間だけ役立ちます。プロジェクトが既に進んでいる場合、古い決定は有害となる可能性があります。更新および削除操作により、アプリケーションは保存されたすべてのレコードを永続的な真実として扱うのではなく、メモリを現在の状態に同期させることができます。
Oracleが保存しているものを検査する
このノートブックはOracleテーブルを直接検査します。これは、開発者がSDKが返した内容だけでなく、実際に保存された内容を確認できるようにするために役立ちます。
このテーブルには、ID、ベクトル、およびJSONペイロードが含まれています。これは便利な分割です。IDは、アプリケーションが更新または削除するための安定した情報を提供します。ベクトルは類似性検索をサポートします。ペイロードには、アプリケーションとそれをデバッグする開発者がメモリを理解しやすくするためのフィールドが含まれています。
ペイロードには、user_id、agent_id、category、メモリテキストなどのフィールドが含まれています。これにより、開発およびデバッグ時に保存されたレコードを理解しやすくなります。
Oracle table exists: True
Table rows: 5
Columns:
- ID: VARCHAR2
- VECTOR: VECTOR
- PAYLOAD: JSON
サンプル行には、エージェントの指示1つ、ユーザーAの食事、映画、旅行の記憶、そして削除後に残ったユーザーBの映画記憶1つが示されています。これが想定される最終状態です。
このような検査は、データベースを基盤としたパターンが実用的である理由の一つです。取得結果に異常が見られる場合、該当する行が存在するか、メタデータが正しく保存されているか、ライフサイクル操作によってテーブルが想定どおりに変更されたかなどを確認できます。
生メモリペイロードを1つ検査する
ノートブックはさらに一段階深く進み、更新されたユーザーAの映画メモリ用の生のJSONペイロードを1つ出力します。
これは、以前の最終証明セクションに代わるものです。以前は要約辞書で終わっていましたが、ノートブックはコアフローの最後に、Oracleが実際に1つのメモリ行に対して保持した内容を表示するようになりました。これは、Python APIの結果とデータベースレコードを関連付けるため、開発者向けチュートリアルにとってより有用です。
生データには、カテゴリ、ソース、ユーザーID、役割、メモリテキスト、ハッシュ、作成タイムスタンプ、更新タイムスタンプ、およびレンマ化テキストなどのフィールドが含まれています。これらのフィールドは、直接検査がなぜ重要なのかを説明しています。ベクトル列は類似性検索をサポートするものですが、JSONペイロードはレコードを理解しやすく、デバッグ可能にするものです。
これはトラブルシューティングの手順としても有効です。アプリケーションが誤ったメモリを取得した場合、ペイロードを調べます。スコープフィールドが正しいか確認します。カテゴリが想定どおりに保存されているか確認します。テキストが更新されているか確認します。メモリIDが、アプリケーションが更新または削除しようとしているものと一致しているか確認します。
デモ環境から本番環境への移行方法
実際のアプリケーションで同じパターンを使用する前に、いくつか変更を加えるでしょう。
- 本番環境用の埋め込みプロバイダを使用し、embedding_model_dimsを正しいベクトル次元に設定してください。
- データベースの認証情報は、シークレットマネージャー、ウォレット構成、または管理対象接続プロファイルに保存してください。
- サービスが既にデータベース接続を管理している場合は、アプリケーションが管理するOracle接続プールを使用してください。
- ユーザーID、エージェントID、テナントID、ワークフローID、プロジェクトID、アカウントIDなど、スコープフィールドを慎重に定義してください。
- フィルタリングとデバッグに必要なメタデータフィールドを決定します。
- 大規模コレクション向けにOracleベクターインデックスを有効化し、調整する。
- メモリ容量が増大する前に、保持、更新、削除に関するポリシーを定義してください。
- 予期しない取得結果をデバッグするために、メモリ操作を十分にログに記録する。
- クリーンアップ操作は明示的に記述してください。ノートブックにはオプションのクリーンアップ機能が含まれていますが、レビュー担当者が最終的なテーブルを確認できるように、デモ行はデフォルトで残されています。
これらは、アプリケーションエンジニアリングにおける一般的な懸念事項です。便利な点は、ノートブックが、ゼロから開発するのではなく、強化可能な小規模な動作基盤を提供してくれることです。
Pythonアプリケーションが、スコープとメタデータ付きで後で取得できる永続的なメモリを必要とする場合に、このパターンを使用します。これは、チャットボット、サポートアシスタント、ワークフローサービス、コーディングアシスタント、またはレスポンスを構築する前にコンテキストを必要とするREST APIなどに該当します。
アプリケーションは、メモリの取得を意図的な手順として扱うべきです。適切なスコープを検索し、重要なメタデータフィルタを適用し、返されたメモリを確認します。そして、有用なコンテキストを次のモデル呼び出し、レスポンスビルダー、またはワークフローアクションに渡します。
永続的なアプリケーションメモリは、単なるベクトルのテーブルではありません。それは、アプリケーションが推論できる、制御された取得パスです。
結論
Mem0 PythonとOracle AI Databaseを組み合わせることで、開発者は永続的なアプリケーションメモリを実現するための実用的な方法を得ることができます。Mem0はメモリAPIを処理し、Oracle AI DatabaseはベクトルとJSONペイロードを保存します。アプリケーションは、スコープ付き取得、メタデータフィルタリング、ライフサイクル操作、および検査可能なストレージレイヤーを利用できます。
付属のノートブックはワークフローを効率的に進めるためのものです。Oracleプロバイダの設定、ユーザースコープとエージェントスコープのメモリの追加、メタデータによるフィルタリング、レコードの更新と削除、取得したメモリからのレスポンスの構築、Oracleに保存されたデータの確認などを行います。この同じパターンを、エージェント、アシスタント、チャットボット、REST API、ワークフローサービスなどのバックエンドで実行できます。
よくある質問
これはどのPythonパッケージを使用していますか?
このノートブックは、mem0ai、oracledb、およびpython dotenvを使用しています。
このノートブックはOpenAIを必要としますか?
いいえ。このノートブックは mem0ai==2.1.0 で検証済みで、チュートリアル実行時には Mem0 のエンベッダファクトリを通じて登録された決定論的なローカルエンベッダを使用します。メモリ書き込みには を使用するinfer=Falseため、Mem0 は提供されたメモリテキストを直接保存し、外部 LLM 抽出呼び出しは行いません。最終的なメモリ対応の回答も、外部モデルではなく、ノートブックコードによって取得されたメモリから組み立てられます。本番環境のアプリケーションでは、ローカルエンベッダをその環境で承認された埋め込みおよび LLM プロバイダに置き換えることができます。
なぜノートブックはinfer=Falseを使用しているのですか?
infer=False を指定すると、指定されたテキストがメモリに直接保存されます。これにより、チュートリアルの予測可能性が高まり、保存パスの検証が容易になります。
記憶はどこに保存されているのか?
Mem0 は、メモリ ID、ベクトル、および JSON ペイロードを Oracle テーブルに格納します。ノートブックでは、コレクションは ですMEM0_PY_MEMORY_DEMO。
複数のユーザーが同じコレクションを共有できますか?
はい。ノートブックはユーザーAとユーザーBを同じコレクションに保存し、ユーザーIDフィルターを使用して適切なレコードを取得します。
メモリをユーザーではなくエージェントにスコープすることは可能ですか?
はい。ノートブックはagent_id=”support_agent”のメモリを1つ追加し、エージェントフィルタを使用して検索します。これは、メモリがエンドユーザーではなく、アシスタント、ワークフロー、またはエージェントランタイムに属している場合に便利です。
チャット履歴にすべて保存しておけばいいのでは?
チャット履歴は短時間のセッションには便利ですが、永続的な記憶システムではありません。フィルタリングや更新、選択的な削除が困難です。一方、メモリ上の記録はサイズが小さく、範囲も限定されているため、取得が容易です。
これは、通常のベクトル検索と何が違うのでしょうか?
単純なベクトル検索では類似テキストが見つかります。アプリケーションメモリには、スコープ、メタデータ、ライフサイクル操作、および検査も必要です。ベクトルはシステムの一部にすぎません。
メタデータでフィルタリングできますか?
はい。ノートブックはカテゴリでフィルタリングします。アプリケーションはメタデータフィールドを使用して、ユーザー、エージェント、テナント、カテゴリ、ソース、ワークフロー、またはその他のドメイン値に基づいて検索結果を絞り込むことができます。
ベクトルインデックスを作成すべきでしょうか?
小規模なチュートリアルであれば、インデックスを作成せずに完全一致検索を行うだけで十分です。より大規模なコレクションの場合は、HNSWやIVFなどのOracleベクターインデックスを構成し、ワークロードに合わせて調整してください。
生産開始前にどのような変更がありますか?
本番環境用の埋め込み機能を使用し、認証情報を保護し、スコープフィールドを定義し、インデックス作成を調整し、更新、削除、保持、監査ログに関するポリシーを設定します。


コメント
コメントを投稿